
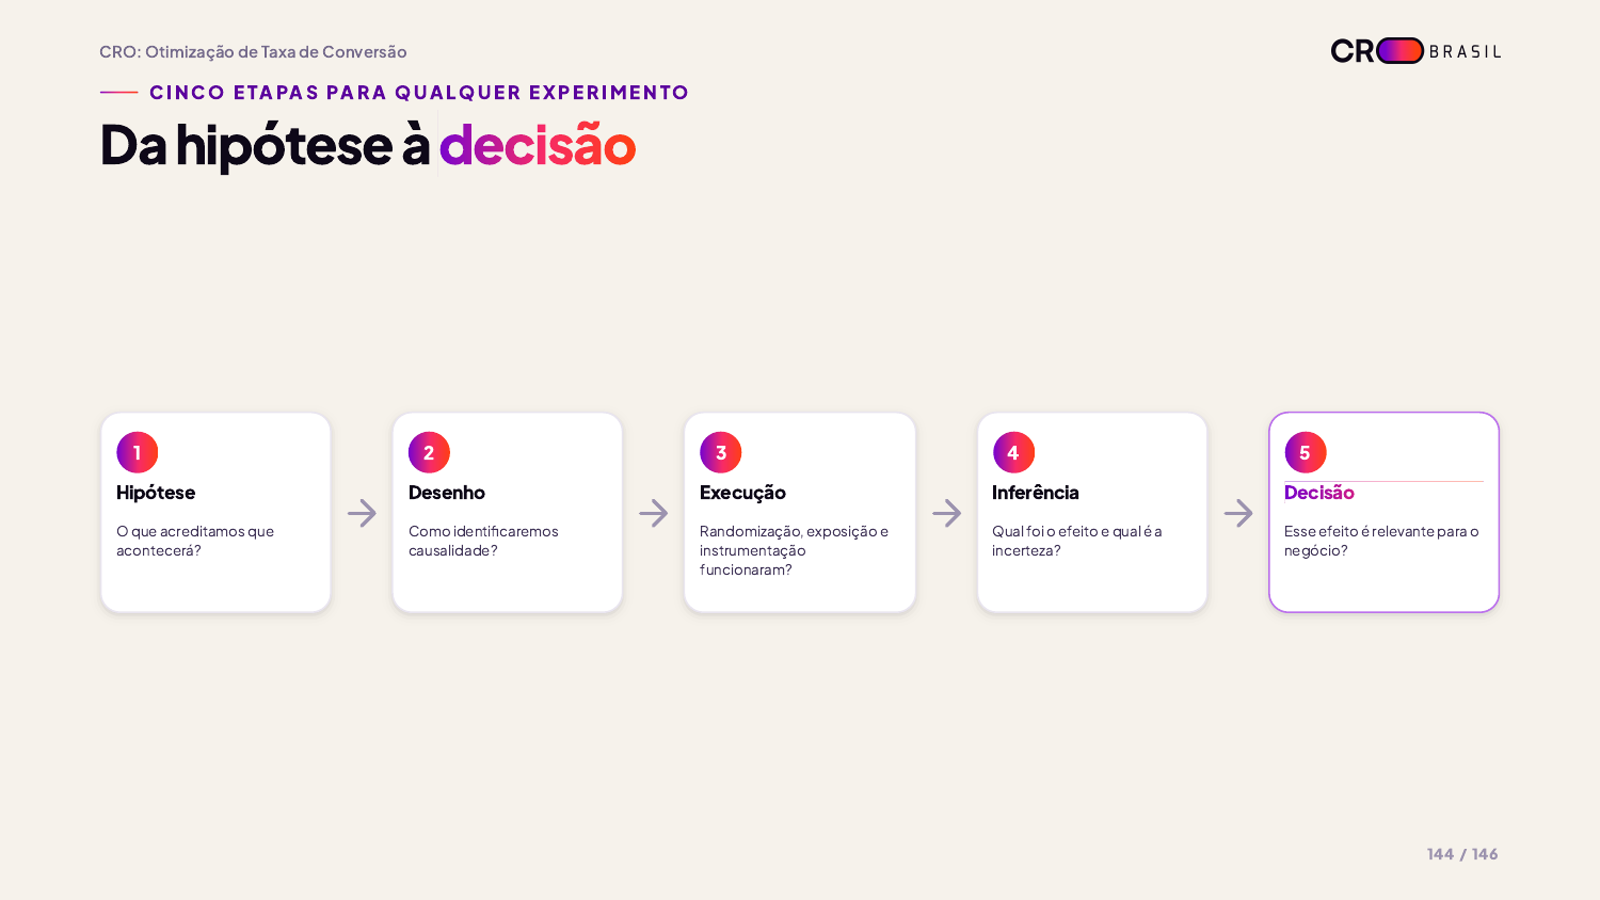
Todo experimento segue cinco etapas: hipótese (o que acreditamos que acontecerá), desenho (como identificaremos causalidade), execução (randomização, exposição e instrumentação funcionaram?), inferência (qual foi o efeito e qual é a incerteza) e decisão (esse efeito é relevante para o negócio?). O trabalho pesado acontece antes de clicar em start.
A maioria dos tutoriais de teste A/B começa na ferramenta. Este começa no planejamento, porque ferramenta nenhuma salva um teste que nasceu errado. Um resultado bonito de um experimento quebrado continua sendo um resultado quebrado.
O experimento começa muito antes do start: os dez passos do planejamento
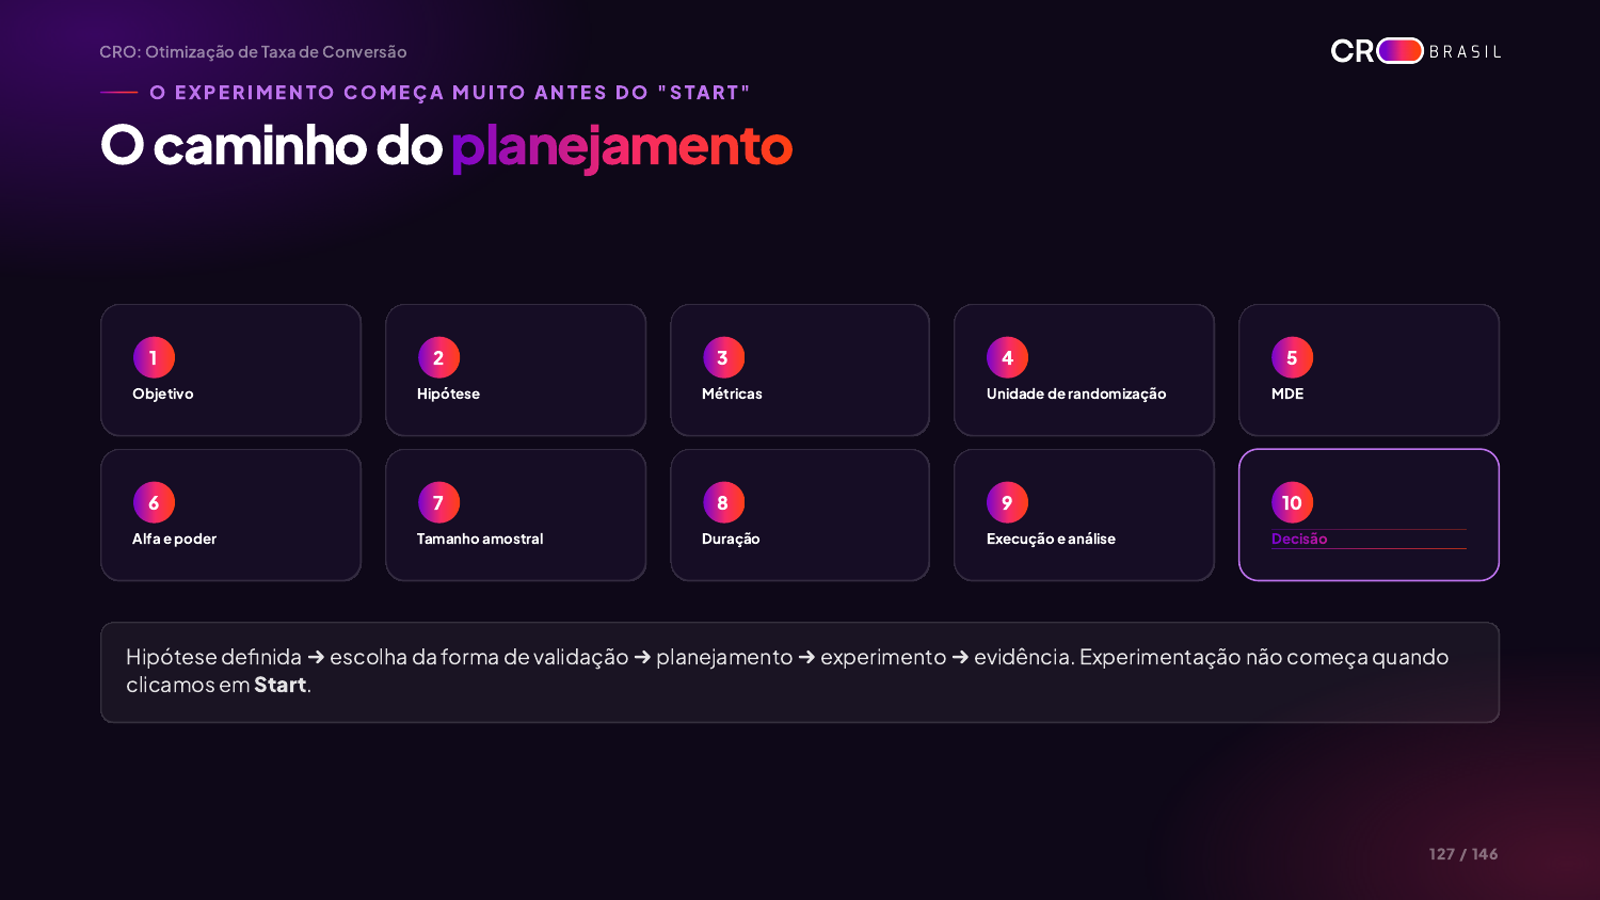
A sequência é: objetivo, hipótese, métricas, unidade de randomização, MDE, alfa e poder, tamanho amostral, duração, execução e análise, decisão. Abaixo, cada passo com o que você precisa definir.
Passo 1: defina o objetivo com dados
O teste nasce de uma evidência sobre o comportamento do usuário: analytics, gravações de sessão, mapas de calor, entrevistas, tickets de suporte. O framework ResearchXL organiza essa investigação. Escreva o problema em uma frase com número: “a página de checkout tem abandono de 78% na etapa de frete”. Sem número, não há problema definido, há impressão. E se a sua lista de ideias veio de um brainstorming, priorize com um framework como PIE, ICE ou PXL antes de gastar tráfego.
Passo 2: escreva a hipótese e torne-a testável
A hipótese de negócio conecta a mudança ao resultado esperado e ao motivo: “reduzir o número de campos do formulário aumentará a conversão, porque diminuímos o esforço percebido”. Depois, traduza para a pergunta estatística que o experimento de fato responde: H₀ afirma que a conversão do tratamento é igual à do controle; H₁ afirma que é maior. O experimento não responde “essa ideia é boa?”. Ele responde uma pergunta precisa e limitada sobre uma diferença entre dois grupos. Temos um guia com modelo pronto de hipótese.
Passo 3: escolha a métrica primária, as secundárias e os guardrails
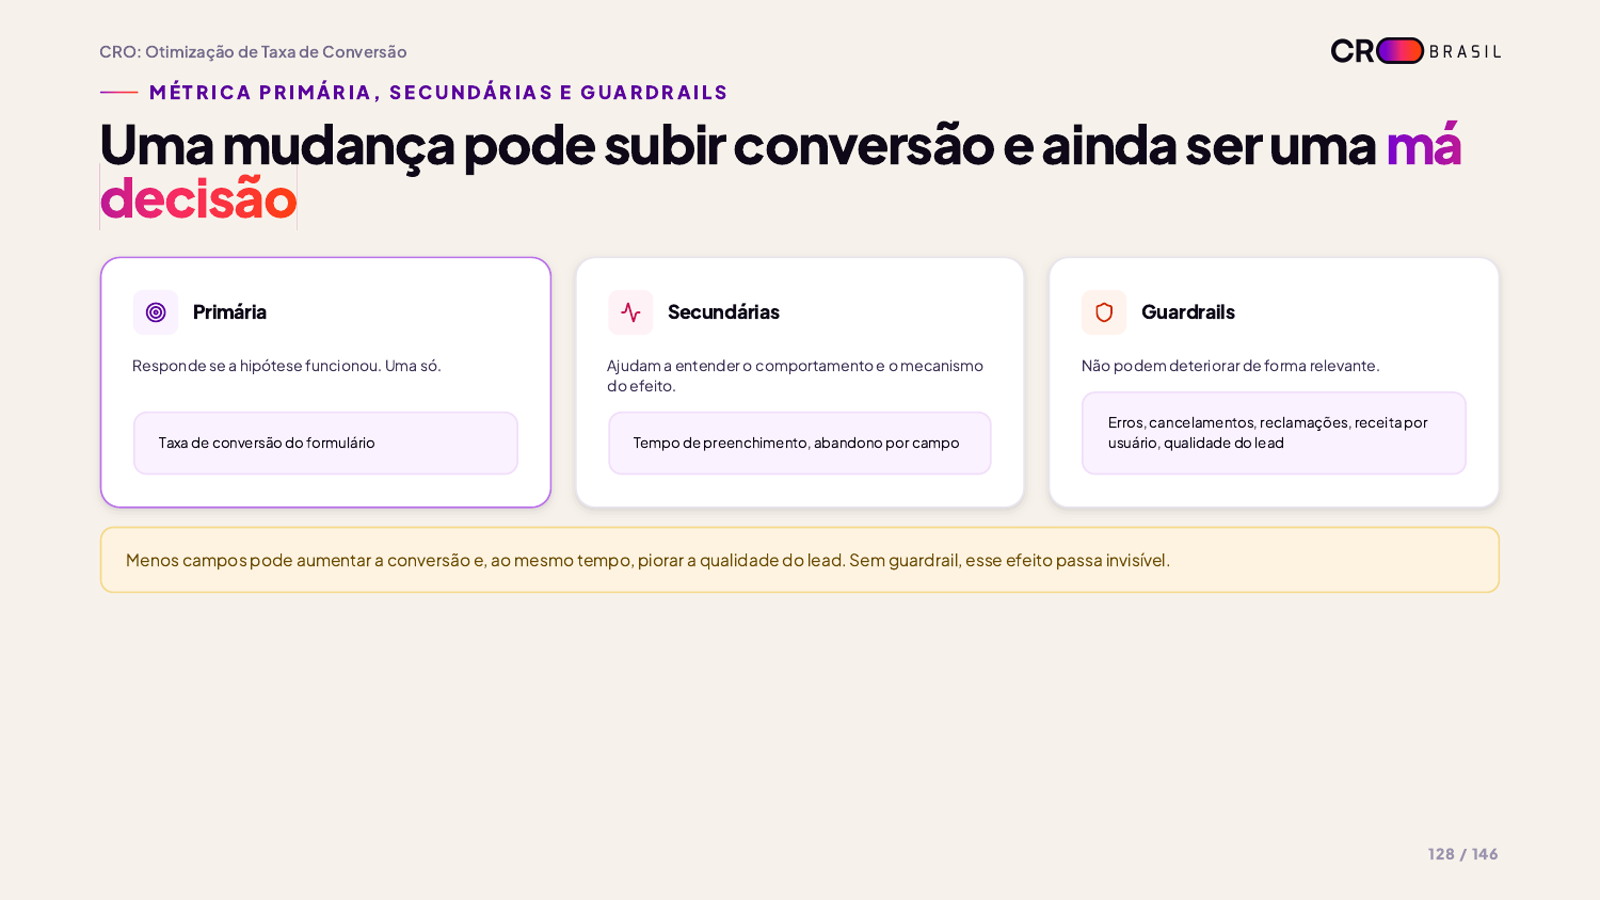
A métrica primária responde se a hipótese funcionou, e é uma só. Nos testes A/B, a taxa de conversão costuma ser a métrica de decisão. As secundárias ajudam a entender o mecanismo do efeito (tempo de preenchimento, abandono por campo) e os indicadores de engajamento explicam o porquê do resultado antes mesmo de ele aparecer na conversão. Os guardrails são as métricas que não podem deteriorar: erros, cancelamentos, reclamações, receita por usuário, qualidade do lead.
O exemplo clássico: menos campos no formulário pode aumentar a conversão e, ao mesmo tempo, piorar a qualidade do lead. Sem guardrail, esse efeito passa invisível e você comemora uma má decisão.
Passo 4: defina a unidade de randomização
A unidade define o que é sorteado: usuário, sessão, conta, pedido, loja, cidade. A unidade errada contamina a comparação. Se a experiência é persistente por usuário e você randomiza por sessão, a mesma pessoa vê A e B, e o que você mede deixa de ser a diferença entre versões.
Passo 5: conheça o comportamento normal do sistema
Antes de dimensionar o teste, levante quatro coisas: a média (nível atual da métrica), a variância (quanto ela oscila naturalmente), o volume (usuários elegíveis por dia) e a sazonalidade (dias de semana, fins de semana, ciclos de decisão do cliente). Sem conhecer a variabilidade normal, qualquer oscilação parece efeito.
Passo 6: defina o MDE, o menor efeito que vale detectar

O Minimum Detectable Effect é a pergunta: qual é o menor efeito que valeria a pena detectar? Com conversão atual de 10%, detectar mais 0,1 ponto percentual exige amostra enorme; mais 0,5 ponto é detectável em prazos razoáveis em muitos contextos; mais 2 pontos pede amostra menor, mas pode ser otimista demais para a mudança proposta. MDE não é só estatística: é estatística, economia e negócio na mesma decisão.
Passo 7: escolha alfa e poder, os dois erros que aceitamos correr
Não existe experimento sem risco de erro. Existe experimento em que escolhemos conscientemente quanto risco aceitar de cada lado:
- Alfa (erro tipo I): o risco de concluir que existe efeito quando não existe, o falso positivo. Convenção usual: 5%.
- Poder (erro tipo II): a probabilidade de detectar um efeito de determinado tamanho quando ele existe. Convenção usual: 80%. O complemento é o falso negativo.
Se você testa muitas variantes ao mesmo tempo (A/B/n, MVT), lembre: várias comparações simultâneas aumentam a chance de ao menos um resultado significativo ao acaso. Testar muitas variantes não é errado; errado é interpretar cada uma como se fosse a única comparação feita. Nesses casos, correções como Bonferroni ou Tukey entram em cena.
Passo 8: calcule a amostra e a duração antes de começar
A amostra não é escolhida por conveniência. As entradas são a métrica histórica, o MDE, o alfa e o poder; o cálculo entrega o tamanho amostral por grupo; a realidade (tráfego elegível disponível) define a duração estimada. A calculadora de Evan Miller faz a conta, mas a ferramenta só entrega uma boa resposta quando recebe boas premissas: você precisa saber por que escolheu aquele MDE, qual baseline usou e qual unidade está sendo randomizada. Detalhes no artigo de estatística de teste A/B.
A duração também precisa cobrir ciclos completos de negócio: dias de semana, fim de semana e o ciclo de decisão do cliente. Teste que pega só um recorte da semana mede um recorte do público.
Passo 9: execute, monitore a saúde do teste e só então analise
Antes de falar de vencedor, responda: a randomização funcionou? Houve SRM? A exposição ocorreu corretamente? A instrumentação está certa? A amostra planejada foi atingida? A duração foi adequada? Houve anomalia operacional? Só então pergunte qual foi o efeito.

O Sample Ratio Mismatch é o sinal de alerta mais importante: se o planejado era 50/50 e o observado é 62/38, algo quebrou na randomização, na implementação, na elegibilidade, na exposição, no tracking ou na infraestrutura, e a comparação não é mais confiável.
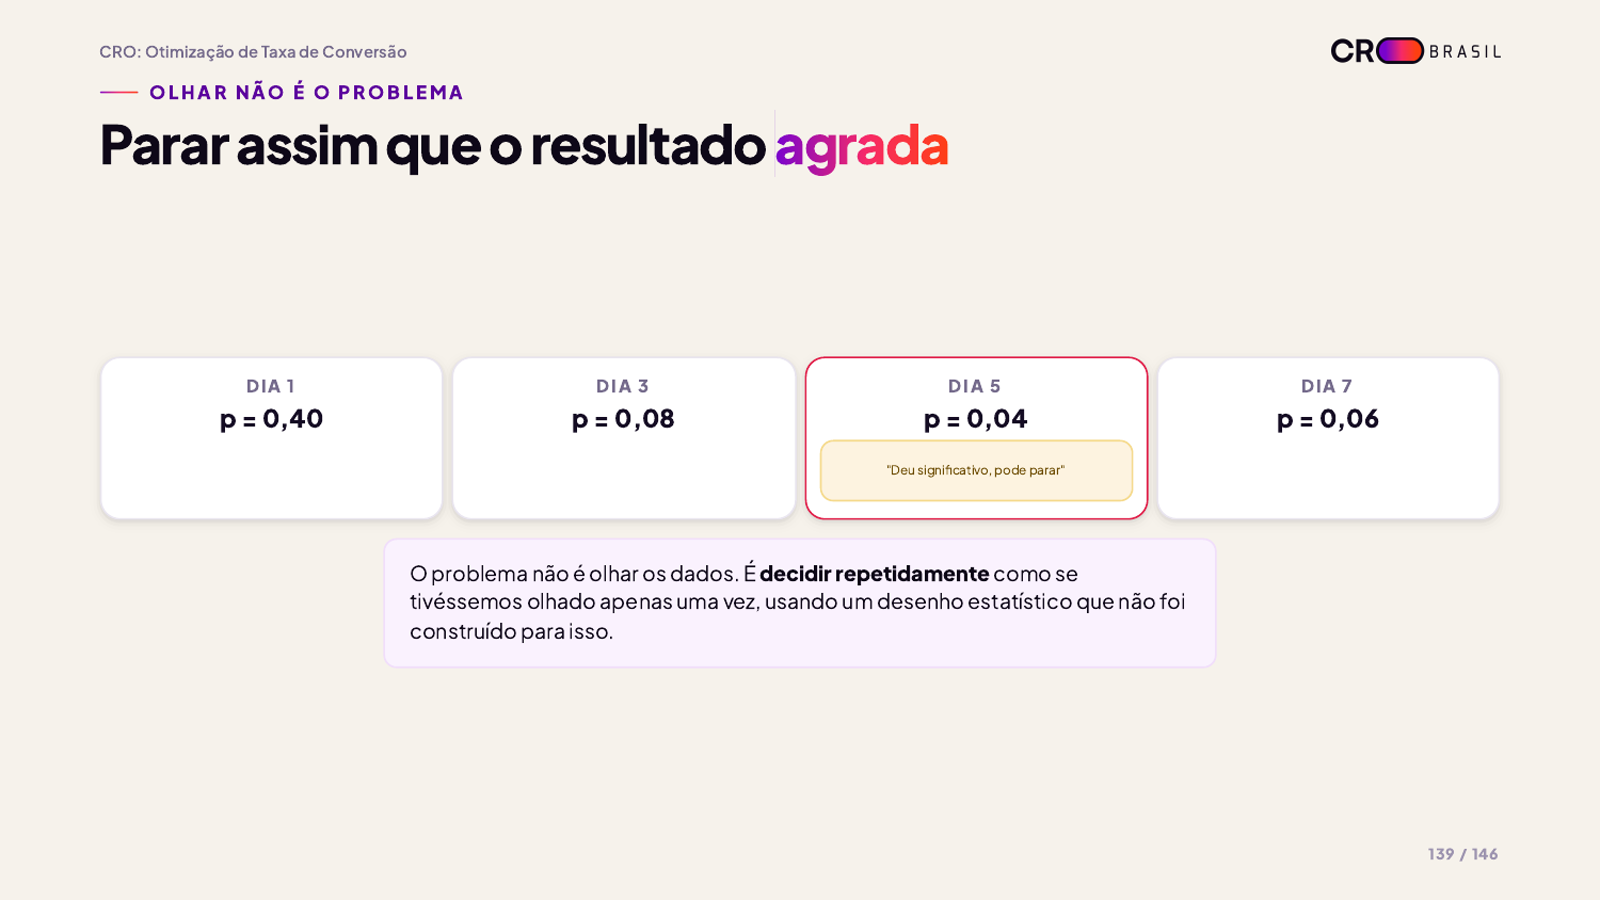
O segundo erro clássico é o peeking: olhar o resultado todo dia e parar quando a variação “ganha”. No exemplo do material de referência, o p-valor foi de 0,40 no dia 1, 0,08 no dia 3, 0,04 no dia 5 (“deu significativo, pode parar”) e 0,06 no dia 7. O problema não é olhar os dados; é decidir repetidamente como se tivéssemos olhado uma única vez, usando um desenho estatístico que não foi construído para isso. Existe forma correta de olhar antes do fim: sequential testing e group sequential testing ajustam o critério justamente porque as análises intermediárias fazem parte do desenho.
E quando o teste termina, interprete o p-valor direito: p = 0,03 não significa “3% de chance de H₀ ser verdadeira” nem “97% de chance de o tratamento funcionar”. Significa que, se H₀ fosse verdadeira, observar dados tão extremos quanto estes teria probabilidade de aproximadamente 3%. O p-valor descreve os dados sob uma hipótese, não a probabilidade da hipótese.
Passo 10: decida como negócio, não como calculadora
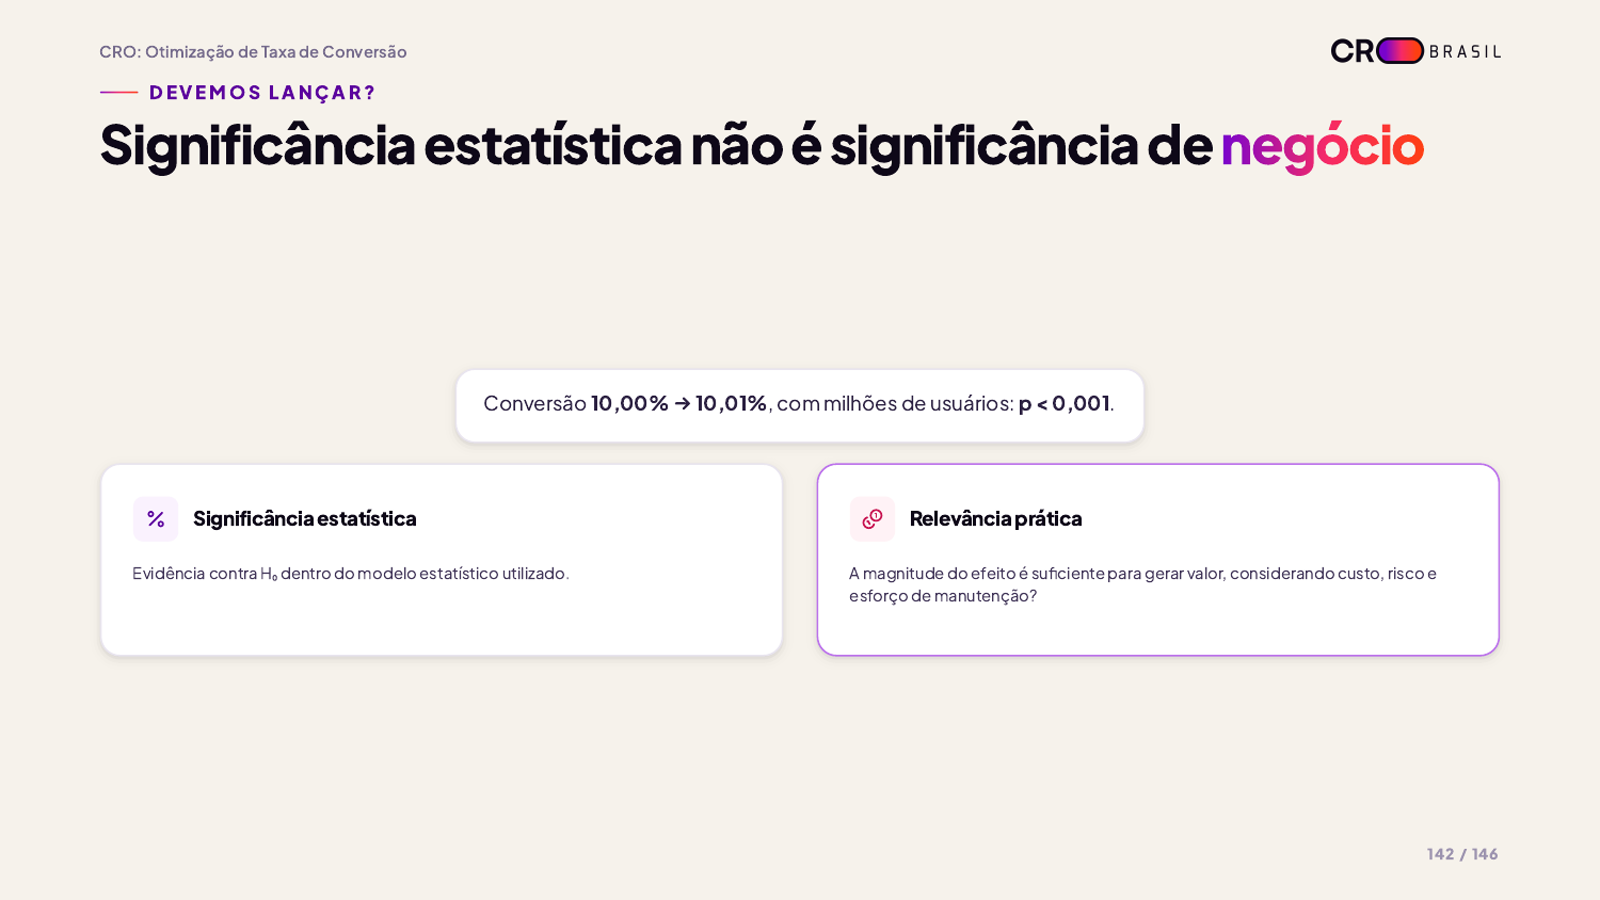
Significância estatística não é significância de negócio. Uma conversão de 10,00% para 10,01%, com milhões de usuários, sai com p < 0,001, e ainda assim o efeito pode não pagar o custo, o risco e o esforço de manutenção. A decisão combina magnitude, incerteza, impacto financeiro, guardrails, risco, estratégia, experiência do cliente e capacidade operacional. As saídas honestas são três: implementar, não implementar, investigar ou repetir.
Três frases que travam a experimentação
- “Não se testa bug.” Correções também geram efeitos colaterais e impactos diferentes por segmento. Mas nem toda correção pede A/B: às vezes o certo é QA, canary release, teste automatizado e monitoramento.
- “Temos certeza de que funciona.” Intuição é fonte de hipótese, não de evidência. Se já soubéssemos o resultado, não precisaríamos experimentar.
- “Não temos tráfego suficiente.” Antes de desistir: revise o MDE, escolha métricas mais sensíveis, reduza a variância com covariáveis (CUPED, estratificação) e melhore o desenho experimental. O problema raramente é ter pouco tráfego; é ter pouca informação em relação ao efeito que você quer detectar.
O checklist de ponta a ponta: vinte perguntas antes de decidir
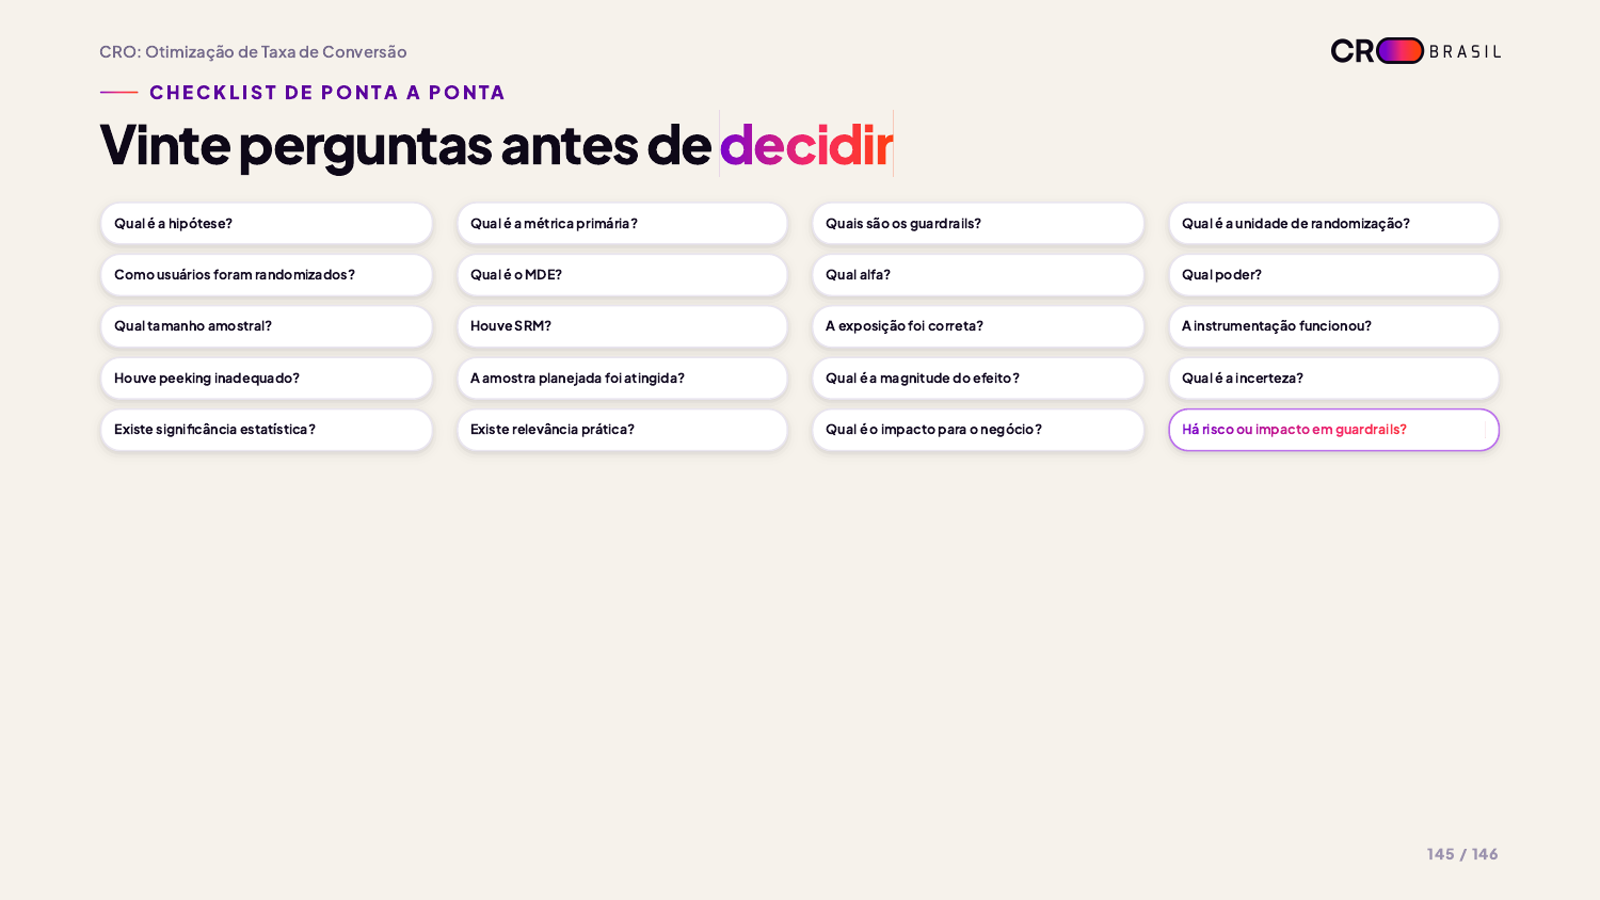
Qual é a hipótese? Qual é a métrica primária? Quais são os guardrails? Qual é a unidade de randomização? Como os usuários foram randomizados? Qual é o MDE? Qual alfa? Qual poder? Qual tamanho amostral? Houve SRM? A exposição foi correta? A instrumentação funcionou? Houve peeking inadequado? A amostra planejada foi atingida? Qual é a magnitude do efeito? Qual é a incerteza? Existe significância estatística? Existe relevância prática? Qual é o impacto para o negócio? Há risco ou impacto em guardrails?
Por fim, documente: hipótese, desenho, resultado e decisão em um repositório que o time inteiro consulta. É isso que transforma testes isolados em um programa de experimentação.
Perguntas relacionadas
Quanto tempo um teste A/B deve durar?
Até atingir a amostra calculada e cobrir ciclos completos de negócio, o que demorar mais. Na prática, raramente menos de duas semanas.
Posso olhar o resultado durante o teste?
Pode olhar, não pode decidir como se tivesse olhado uma única vez. Se monitorar e parar cedo faz parte do plano, use um desenho sequencial, que ajusta o critério de decisão para as análises intermediárias.
E se o teste der inconclusivo?
Inconclusivo é informação: o efeito real da mudança provavelmente é menor que o MDE que você definiu. Documente e decida se vale um novo desenho, com efeito mínimo maior ou métrica mais sensível.
O que é teste A/B, exatamente?
Se você chegou aqui sem essa base, comece pelo guia completo sobre o que é teste A/B e entenda para que ele serve.
Fontes
- Evan Miller, calculadora de tamanho de amostra para teste A/B
- Kohavi, Tang e Xu, Trustworthy Online Controlled Experiments (Cambridge University Press)
- VWO, guia de A/B testing
- Material do curso Otimização de Taxa de Conversão, de Taciana Serafim (CRO Brasil)
Revisão editorial: Taciana Serafim, fundadora e CEO da CRO Brasil. Publicado em outubro de 2026.
A CRO Brasil é a maior comunidade de otimização de conversão do país. Se você quer discutir experimentação com quem vive isso todo dia, conheça a CRO Brasil e participe dos próximos encontros.