
Teste A/B é um experimento controlado e randomizado: o tráfego é dividido por sorteio entre a versão atual (controle) e uma variação (tratamento), e os resultados são comparados para medir o efeito real da mudança. É o método que separa o que funciona do que a gente acha que funciona.
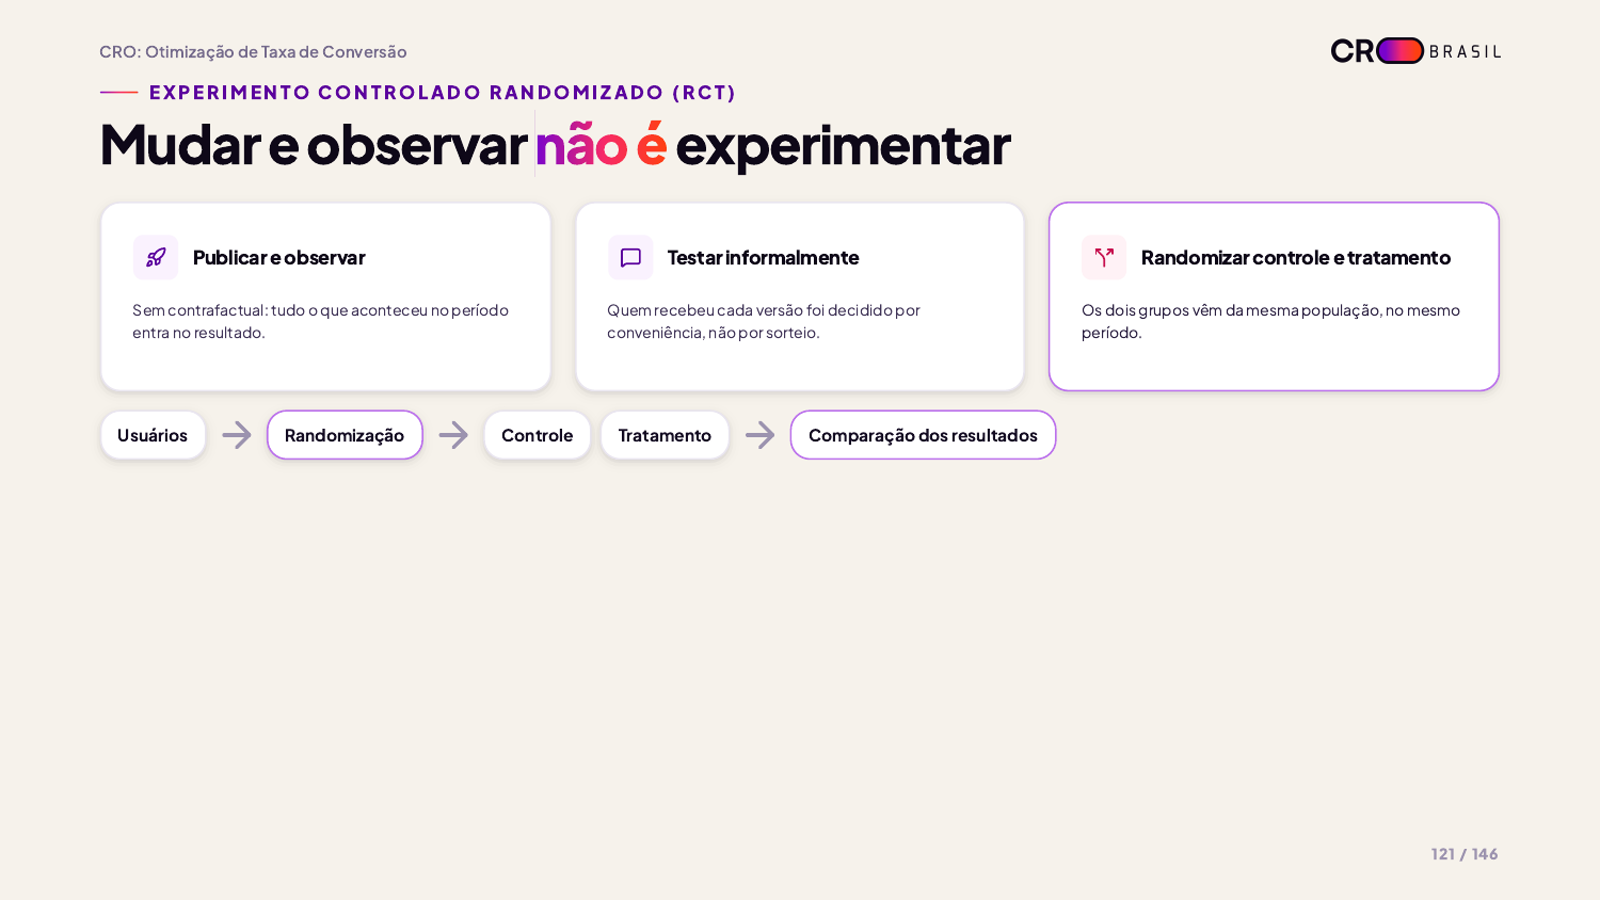
A definição acima parece simples, mas cada palavra dela importa. Controlado: existe um grupo que continua vendo a versão original, porque sem ele não há comparação honesta. Randomizado: quem vê cada versão é decidido por sorteio, não por conveniência. Medir o efeito: o objetivo não é provar que você tinha razão, é descobrir o que funciona para o seu público específico.
Por que a comparação intuitiva falha
Todo time já tentou o caminho mais curto: publicou a página nova, viu a conversão subir 30% e comemorou. O problema é que, no mesmo período, aconteceram campanha nova, promoção, mudança de preço e sazonalidade. Foi a página? Ninguém sabe. Esse é o erro de confundir correlação com causalidade.
Dois vieses explicam quase todas as conclusões erradas:
- Viés de seleção. Quem viu a versão nova já era diferente de quem viu a antiga (canal, dispositivo, intenção de compra). A diferença medida é entre pessoas, não entre versões.
- Variável omitida. Algo que não entrou na conta explica os dois lados ao mesmo tempo. O exemplo clássico: o verão aumenta o consumo de sorvete e também os acidentes na praia. Sorvete não causa acidente. Nos dois casos o número está correto; a interpretação causal é que está errada.
Existe ainda a pergunta que nenhum dashboard consegue responder: o que teria acontecido com essas mesmas pessoas se elas tivessem visto a outra versão? Esse cenário hipotético se chama contrafactual, e ele nunca é observável para a mesma pessoa. O grupo controle existe justamente para aproximá-lo.
O mecanismo central: randomização cria grupos comparáveis
Quando o sorteio é bem feito, os dois grupos vêm da mesma população, no mesmo período, e carregam em média o mesmo perfil de dispositivo, renda, idade, comportamento, frequência e histórico de compra. A randomização não torna os grupos idênticos (sempre haverá diferença amostral), mas torna diferenças sistemáticas improváveis, inclusive nas variáveis que não medimos. É isso que permite a inferência causal: se os grupos são comparáveis em tudo, a diferença no resultado vem da única coisa que mudou, a versão.
Na prática, as plataformas fazem o sorteio por um cálculo determinístico: um hash do identificador do usuário com o identificador do experimento gera um valor entre 0 e 1; de 0 a 0,5 vai para o controle, de 0,5 a 1 para o tratamento. Parece aleatório, mas não é, e é assim que o mesmo usuário fica preso à mesma versão e experimentos diferentes rodam em paralelo sem se contaminar. O que não funciona: último dígito de CPF, usuários alternados em fila, ou qualquer regra ligada a uma característica do comportamento.
Do achismo ao método
Existe uma escala de maturidade na forma de decidir mudanças digitais:

No primeiro degrau está a opinião: “acho que vermelho vende mais”, baseado em gosto pessoal, sem validação e com alto risco de viés. Um degrau acima estão as boas práticas: melhor que o palpite, mas baseadas em benchmarks de outras empresas, que nem sempre se aplicam ao seu público. No topo está o CRO sistemático: decisões baseadas em dados e hipóteses, testadas com experimentos reais, validadas estatisticamente, com risco controlado. O objetivo do teste A/B não é ter razão; é descobrir.
A realidade da experimentação: até os melhores erram na maioria das vezes
Aqui está o número que muda a relação de um time com testes: na distribuição típica de resultados de testes A/B, apenas cerca de 25% geram impacto positivo. Aproximadamente 60% não mostram diferença significativa e cerca de 15% pioram o resultado.
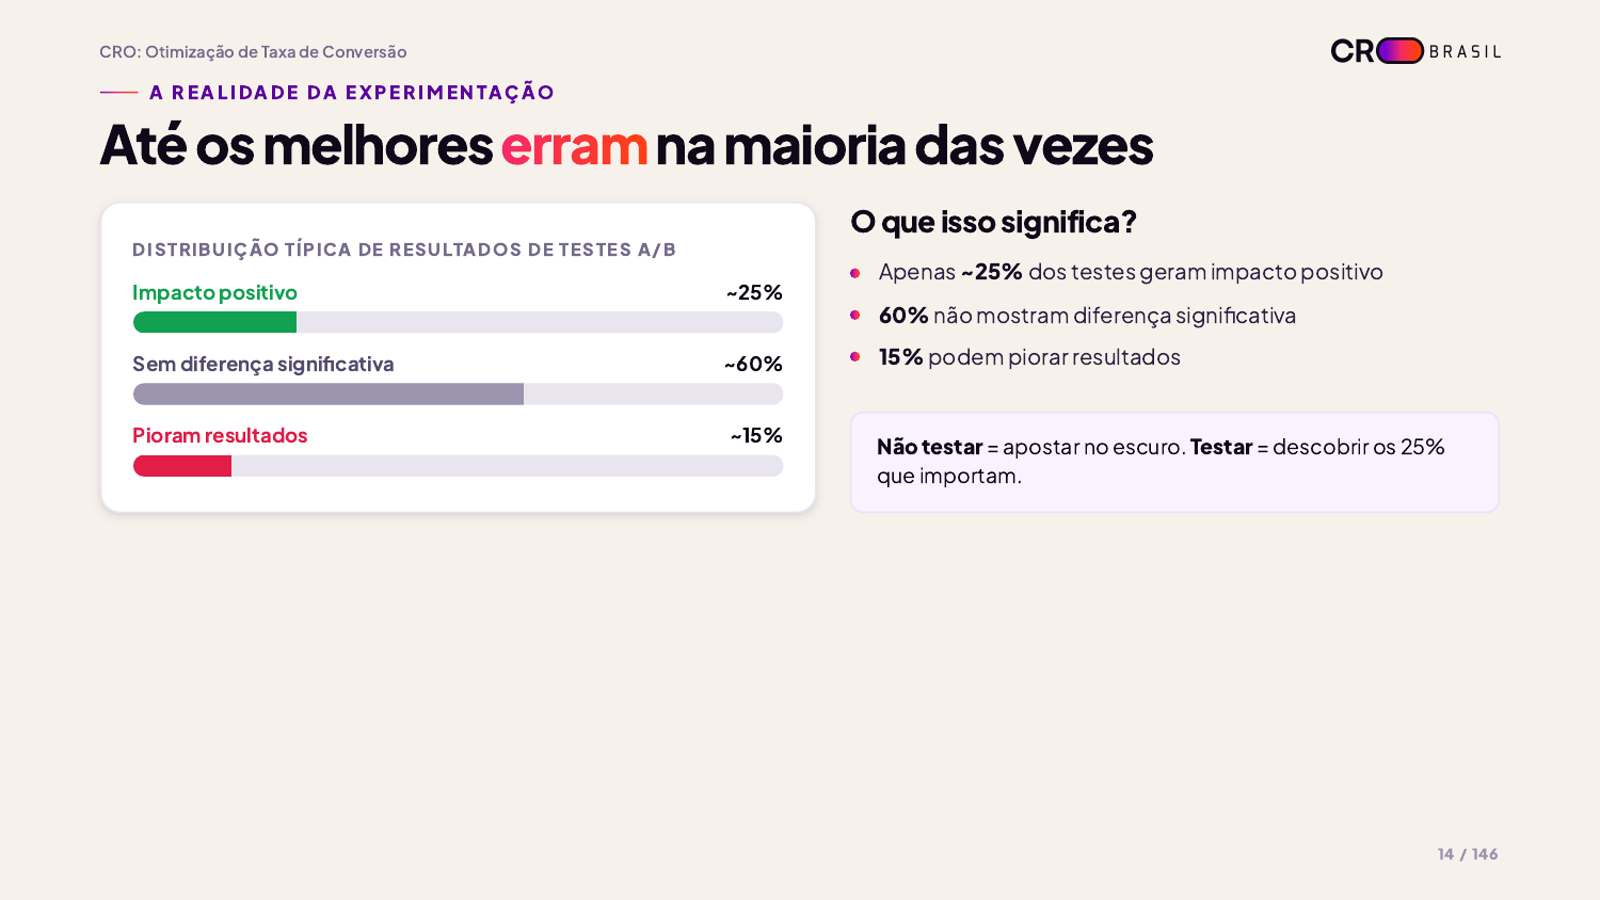
Isso não é argumento contra testar, é o contrário. Não testar é apostar no escuro; testar é descobrir quais são os 25% que importam. O sucesso em experimentação é probabilístico, não diário: o foco está nos resultados de longo prazo, aceitando que perdas pontuais vão acontecer. O verdadeiro ganhador consistente aceita o risco em cada decisão, opera com uma vantagem estatística testada, aceita o erro tão naturalmente quanto o acerto e controla as perdas imediatamente.
O teste que perdeu, mas economizou milhões
Um e-commerce estava prestes a lançar um checkout novo, que o time tinha certeza de que converteria mais. Antes de subir para 100% do tráfego, rodaram um teste A/B. O resultado: a variante converteu 2,68% contra 3,10% do controle, uma queda de 13,5%, com 99% de confiança estatística.
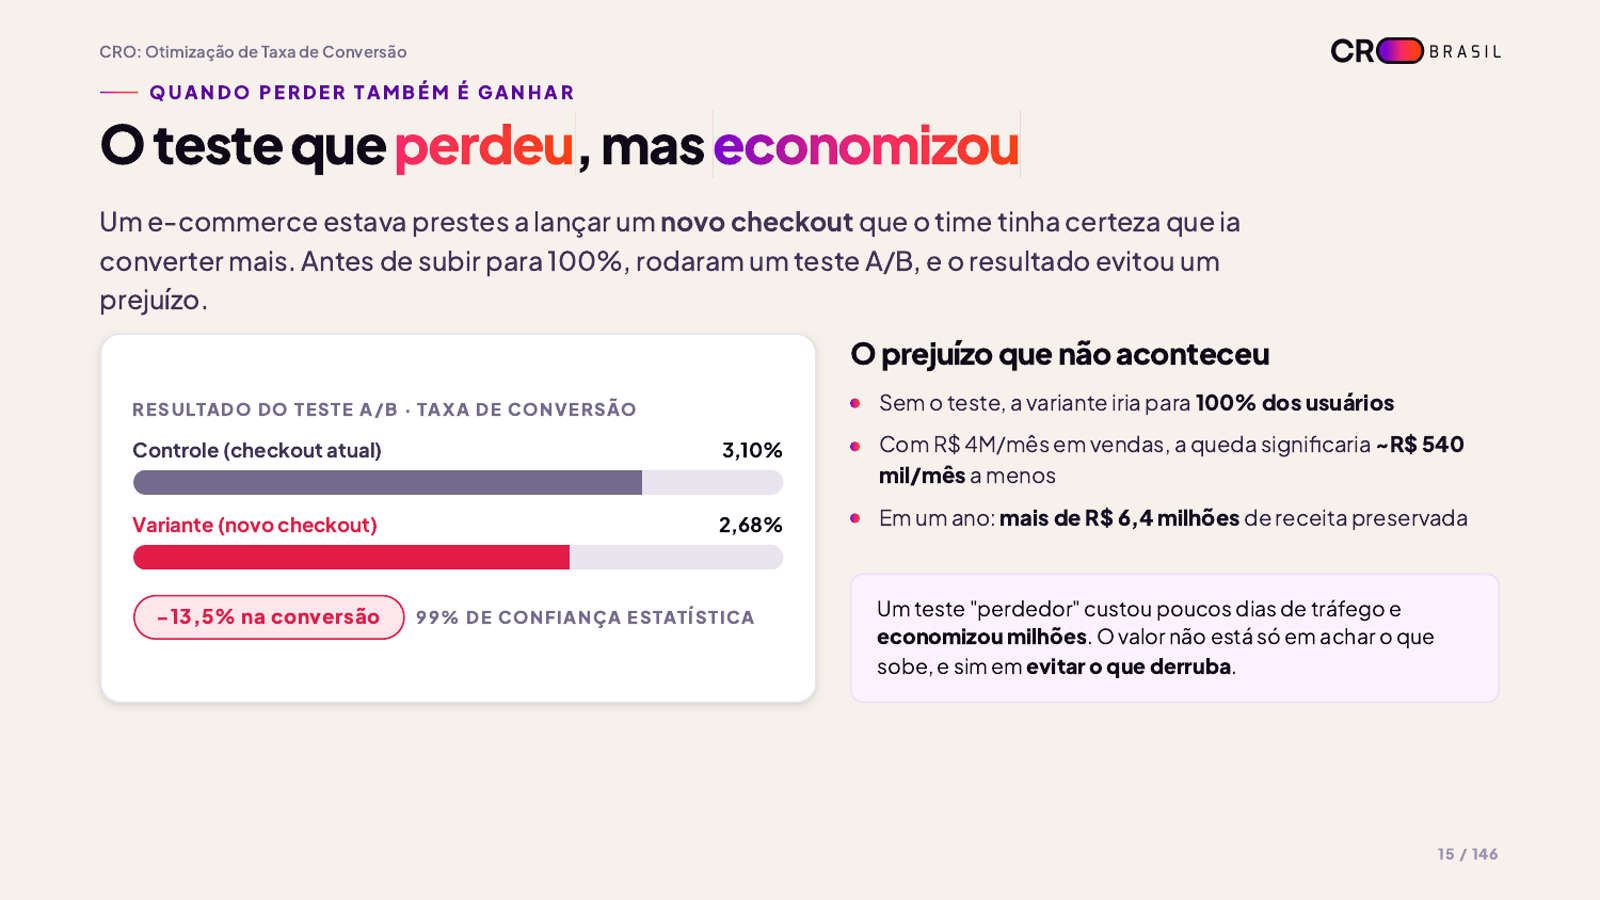
Sem o teste, a versão pior iria para todos os usuários. Com R$ 4 milhões por mês em vendas, a queda significaria cerca de R$ 540 mil a menos por mês, mais de R$ 6,4 milhões em um ano. Um teste “perdedor” custou poucos dias de tráfego e economizou milhões. O valor do teste A/B não está só em achar o que sobe; está em evitar o que derruba.
Como as empresas que mais experimentam usam o teste A/B
Google. Mais de 10 mil experimentos por ano. Em um dos mais famosos, testaram 41 tons de azul antes de decidir a cor dos links, e a cor vencedora rendeu mais de US$ 200 milhões por ano.
Netflix. 80% do conteúdo assistido vem de recomendações testadas, e a cultura de experimentação em thumbnails, algoritmos, interface e copy representa cerca de US$ 1 bilhão por ano em retenção. Um exemplo: revisitaram o campo de e-mail na home, um padrão que antes não tinha funcionado, e a variante sem a linha do tempo do período grátis venceu o controle.
Booking.com. Mais de mil testes A/B rodando ao mesmo tempo, o tempo todo, e qualquer funcionário pode lançar um experimento sem aprovação prévia. Nem todo teste vence: ao testar mostrar a “caminhabilidade” do bairro na página do hotel, hipótese nascida de pesquisa qualitativa, o resultado não teve impacto significativo e a versão atual seguiu campeã. Errar a maioria e ainda assim vencer é o modelo.
Exemplos reais de teste A/B no Brasil
Experimentos documentados aqui no CRO Brasil:
- A Coris Brasil testou remover o banner principal da landing page e dobrou as conversões em quatro meses: veja o case completo.
- O Sorte Online reposicionou a vitrine de bolões e subiu o add to cart em 6,7%: um teste simples de hierarquia visual.
- A AURUM aplicou experimentação no fluxo de trial e multiplicou a ativação por quatro.
- Um e-commerce testou imagens de produto maiores e aumentou a receita em 9,46%: o case está aqui.
Teste A/B e seus vizinhos: o vocabulário de experimentação
O teste A/B é o mais conhecido, mas convive com outras formas de validar hipóteses, e elas não significam a mesma coisa:

- Teste A/B: duas experiências comparadas, controle versus tratamento.
- Teste A/B/n: o controle contra duas ou mais variantes ao mesmo tempo.
- MVT (teste multivariado): testa combinações de elementos, título vezes imagem vezes CTA, e exige muito mais amostra.
- Redirect ou split URL: compara experiências em URLs ou implementações diferentes.
- Fake door: valida interesse antes de construir (um botão “quero esse recurso” que ainda não existe). É técnica de validação, não outro nome para A/B.
- MAB (multi-armed bandit): adapta a distribuição de tráfego ao longo do teste, favorecendo o que performa melhor.
- Personalização: experiências diferentes por público, comportamento ou contexto, e também pode ser validada experimentalmente.
Não é preciso decorar os nomes. É preciso entender qual pergunta queremos responder e escolher a forma de validação adequada.
O que teste A/B não é, e quando não é possível experimentar
Teste A/B não é pesquisa de usuário: ele diz o que as pessoas fazem, não por que fazem. Para o porquê, existe pesquisa de conversão. Não é validação de redesign inteiro de uma vez, não é ferramenta de personalização e não é um jeito de confirmar o que já foi decidido. E há situações em que experimentar não é possível: restrições éticas (expor pessoas a situações potencialmente prejudiciais) e restrições operacionais (quando a randomização individual é impossível, como políticas públicas, mídia offline ou mudanças geográficas e estruturais).
Dentro do método de CRO, o teste é uma etapa de um ciclo maior: coleta de dados, análise, hipóteses, priorização, testes, documentação e escala. Se você quer o panorama, comece por o que é CRO.
Perguntas relacionadas
Qual a diferença entre teste A/B e teste multivariado?
No A/B você compara versões completas entre si; no multivariado, combinações de vários elementos ao mesmo tempo, o que exige muito mais tráfego. Para a maioria das empresas brasileiras, o A/B bem feito entrega mais que o MVT maltratado.
Quanto tráfego preciso para fazer um teste A/B?
O problema raramente é ter pouco tráfego; é ter pouca informação em relação ao efeito que você quer detectar. Antes de desistir, revise o efeito mínimo detectável, escolha métricas mais sensíveis e melhore o desenho experimental. Os conceitos estão no artigo de estatística de teste A/B.
Teste A/B prova que a variante é melhor?
Não em absoluto. Ele mede que a variante performou melhor que o controle, naquele público, naquele período, para aquela métrica, dentro de um nível de confiança escolhido. É a melhor evidência disponível, com contexto e incerteza declarados.
Como faço meu primeiro teste A/B?
Siga o passo a passo completo de como fazer um teste A/B. E para entender quando o teste é a ferramenta certa, leia para que serve um teste A/B.
Fontes
- Kohavi, Tang e Xu, Trustworthy Online Controlled Experiments (Cambridge University Press)
- Harvard Business Review, The Surprising Power of Online Experiments
- Optimizely, glossário de A/B testing
- Material do curso Otimização de Taxa de Conversão, de Taciana Serafim (CRO Brasil)
Revisão editorial: Taciana Serafim, fundadora e CEO da CRO Brasil. Publicado em outubro de 2026.
A CRO Brasil é a maior comunidade de otimização de conversão do país. Se você quer discutir experimentação com quem vive isso todo dia, conheça a CRO Brasil e participe dos próximos encontros.