
Um teste client side bem montado pra pessoas deixava o Googlebot, o Bing e os robôs de IA sempre na página original. Entenda o que aconteceu e o que ajustar no seu próximo teste.
Na conversa do grupo da CRO Brasil sobre agentes, surgiu a provocação: como randomizar o que o agente do usuário vai entender sobre você? Eu tinha um caso real que responde uma parte disso. No começo de outubro, a home do Nubank trocava sozinha na minha frente, uns 8 segundos depois de carregar. Era um teste A/B. E quem nunca entrava nesse teste eram justamente os robôs: o Googlebot, o Bing e os de IA.
Se você roda teste A/B em página que precisa estar no Google, vale entender esse caso. O teste estava bem montado pra pessoas, e ainda assim saía das regras que o Google publica.
O que estava rodando na home do Nubank
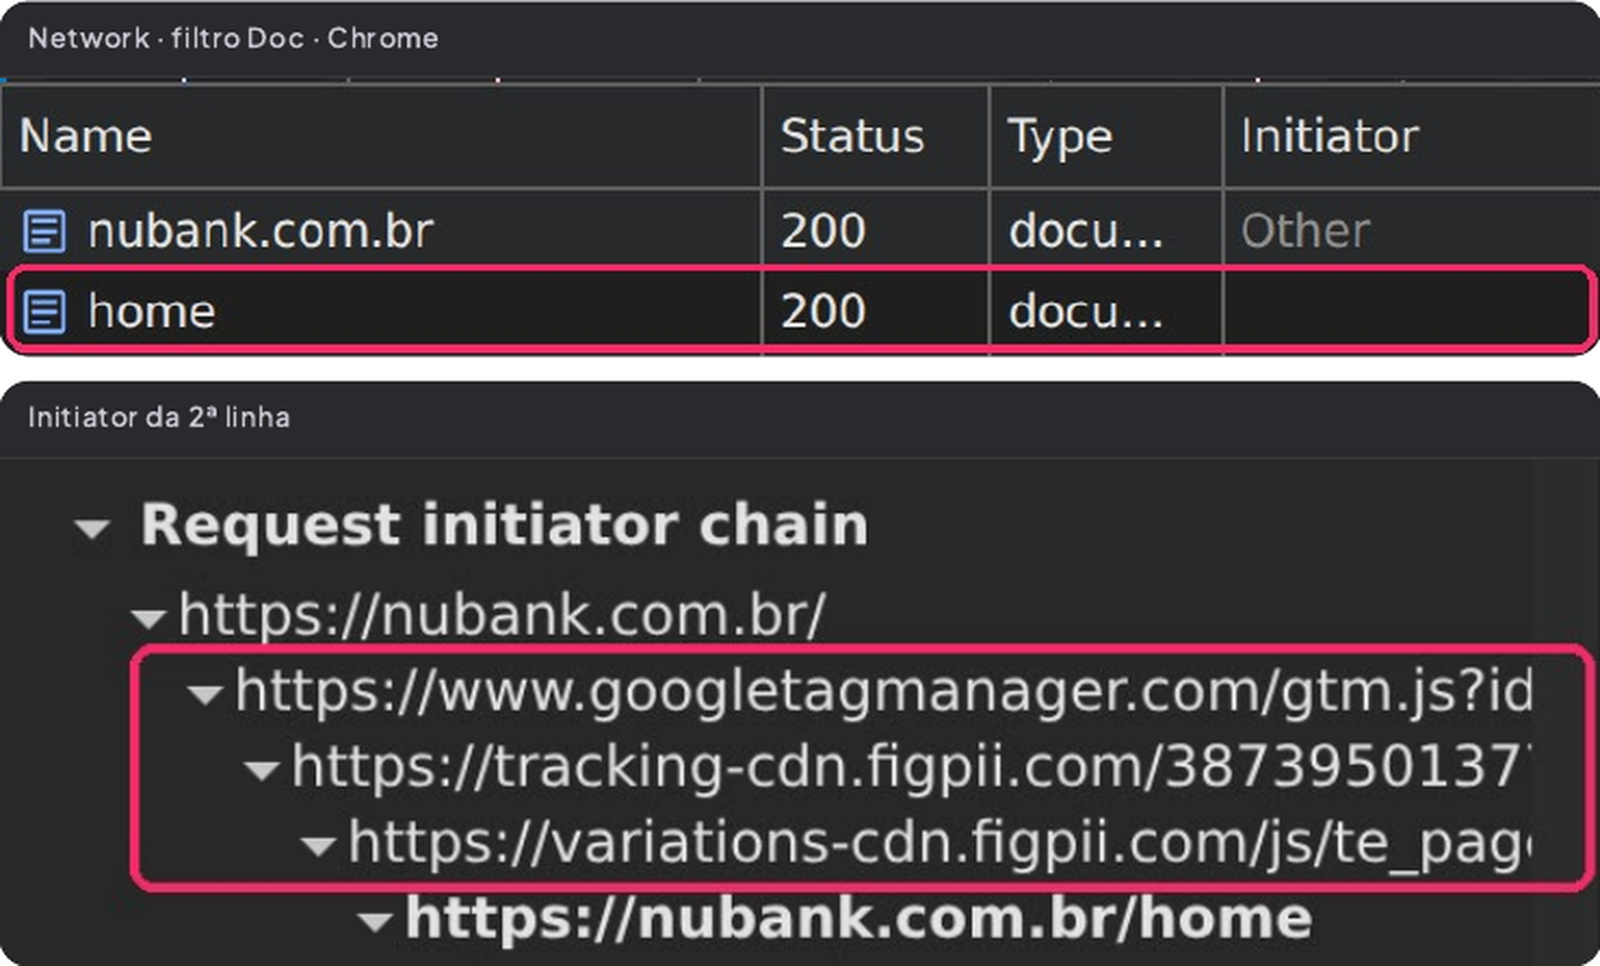
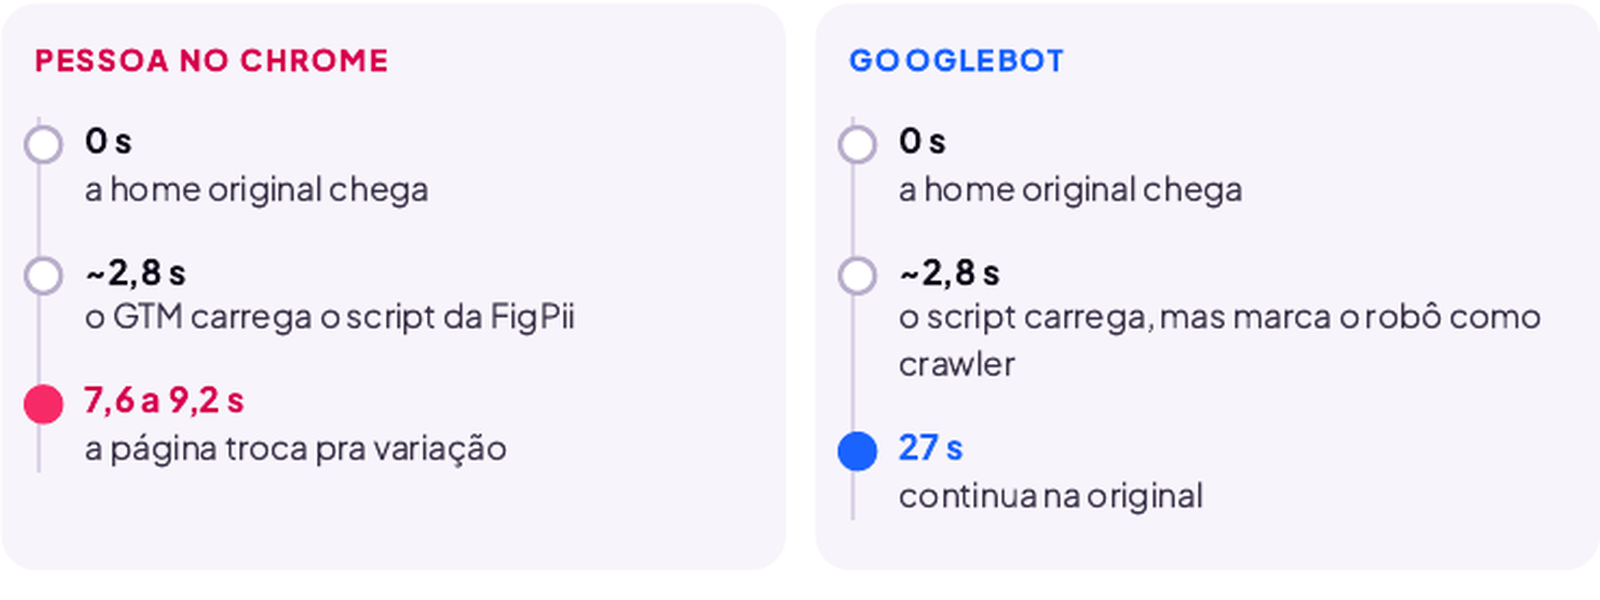
Em 5 e 6 de outubro de 2026, abri o nubank.com.br numa aba anônima, com o DevTools em Network e o filtro Doc. A home carregava normal. Segundos depois aparecia uma segunda linha Doc, com Initiator Script, e a página virava outra. A cadeia era nubank.com.br, Google Tag Manager, FigPii e, por fim, a variação. Nas 7 gravações de 6 de outubro, a troca levou de 7,6 a 9,2 segundos.
A configuração do teste é pública, porque o navegador de qualquer visitante baixa esse arquivo. O experimento se chamava “2026-07 Produtos (Caixinhas vs Nucel) – Homepage”, e o sorteio era este:
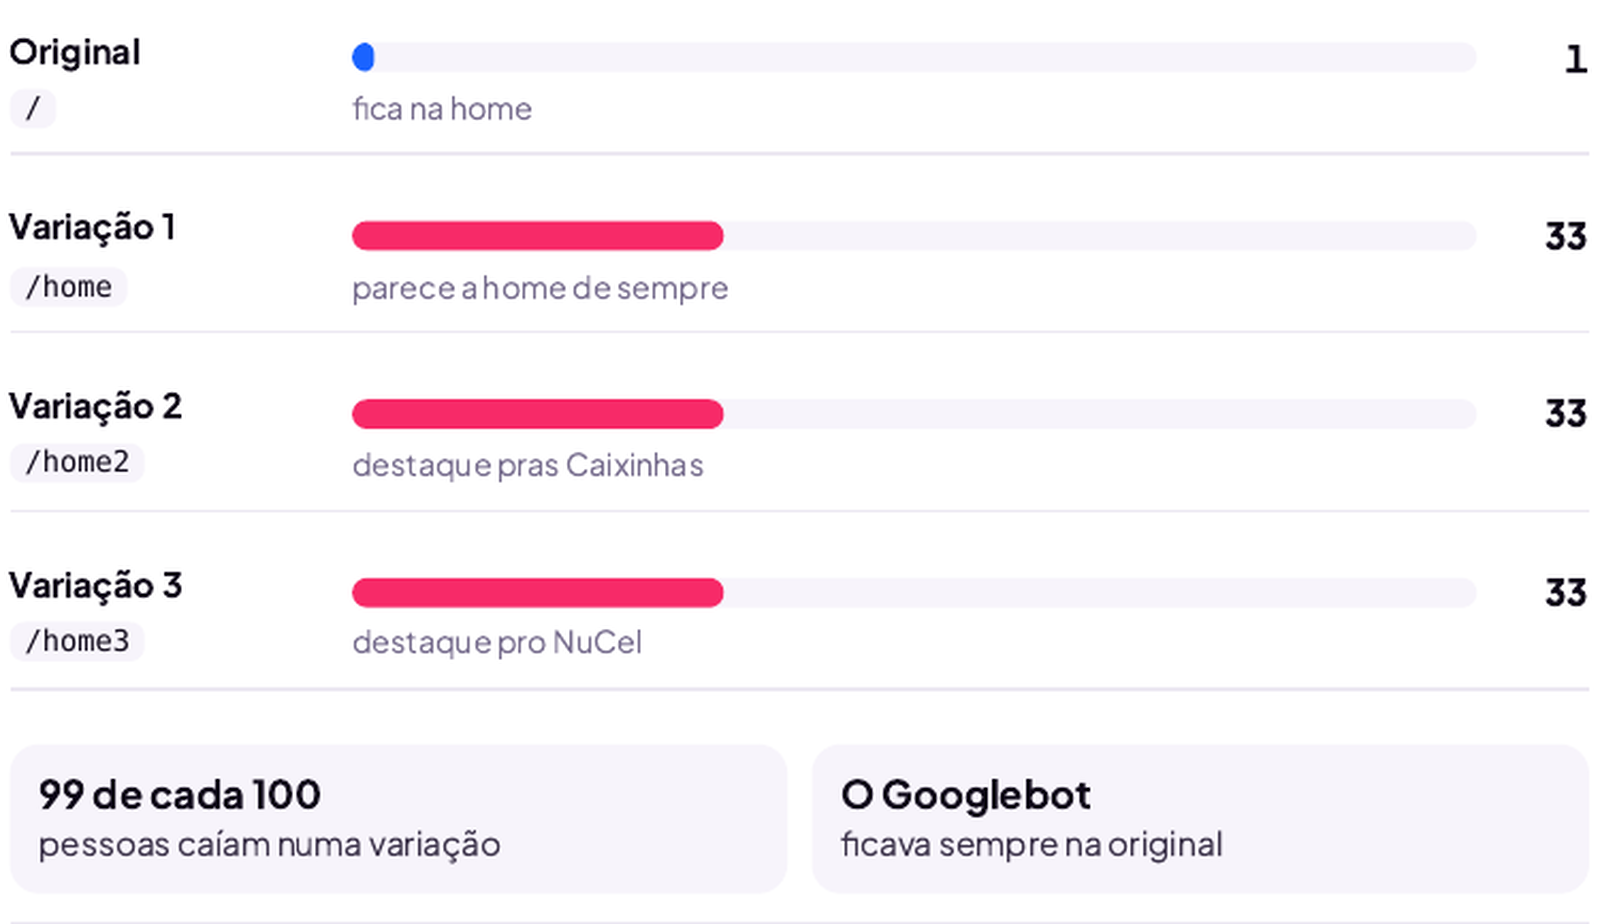
Na minha leitura, a /home faz o papel de grupo controle: ela passa pelo mesmo redirect que as outras, o que deixa a comparação mais justa. É um desenho bem pensado de CRO. Não tenho o painel do teste, então essa parte é inferência.
O que o Google pede num teste A/B
O Google aceita teste A/B e explica como fazer na página “Minimizar o impacto de testes A/B na Pesquisa Google”, da Central da Pesquisa. Os pontos que importam aqui:
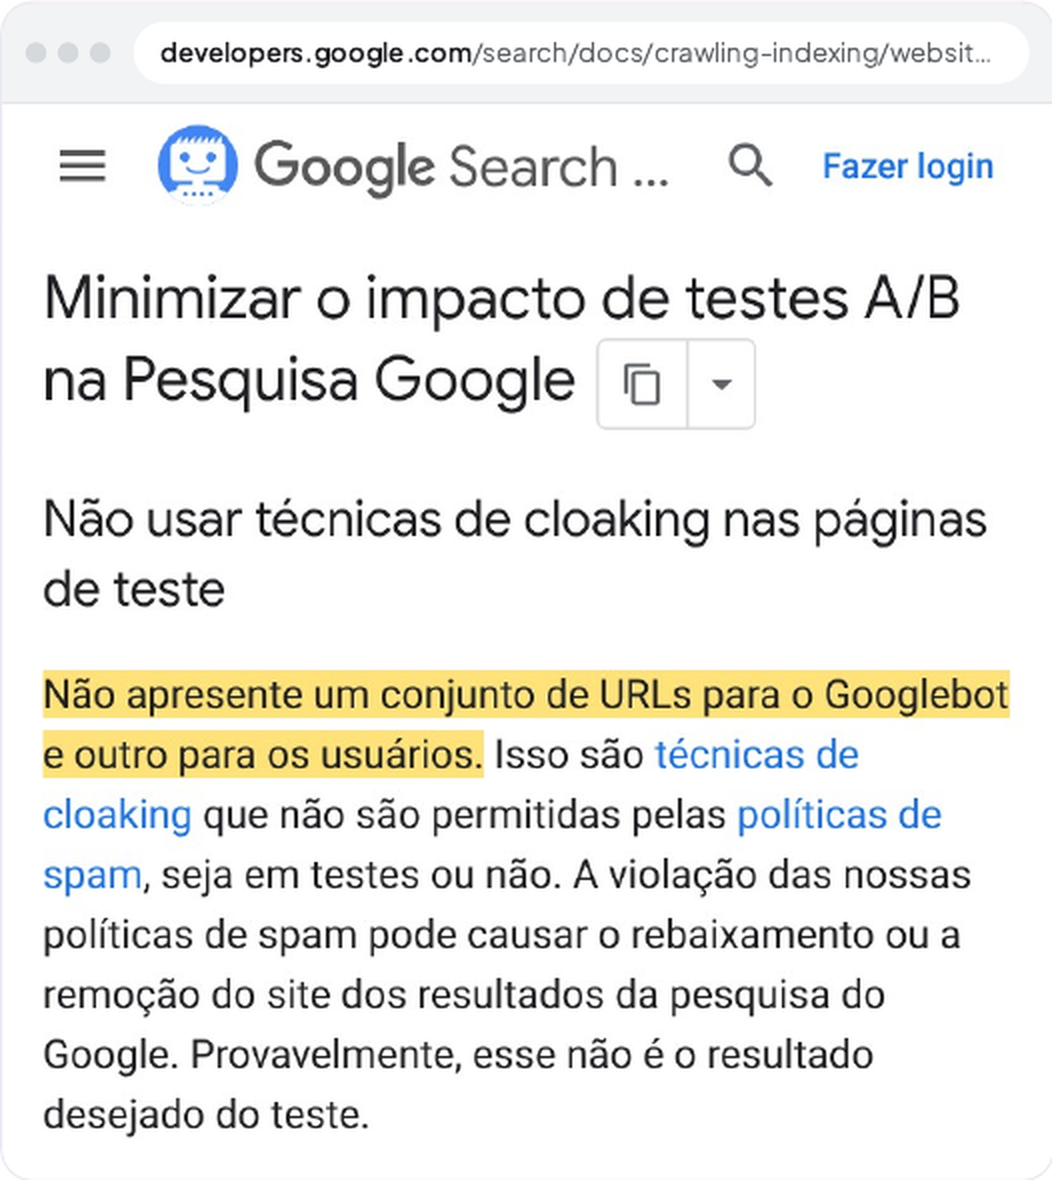
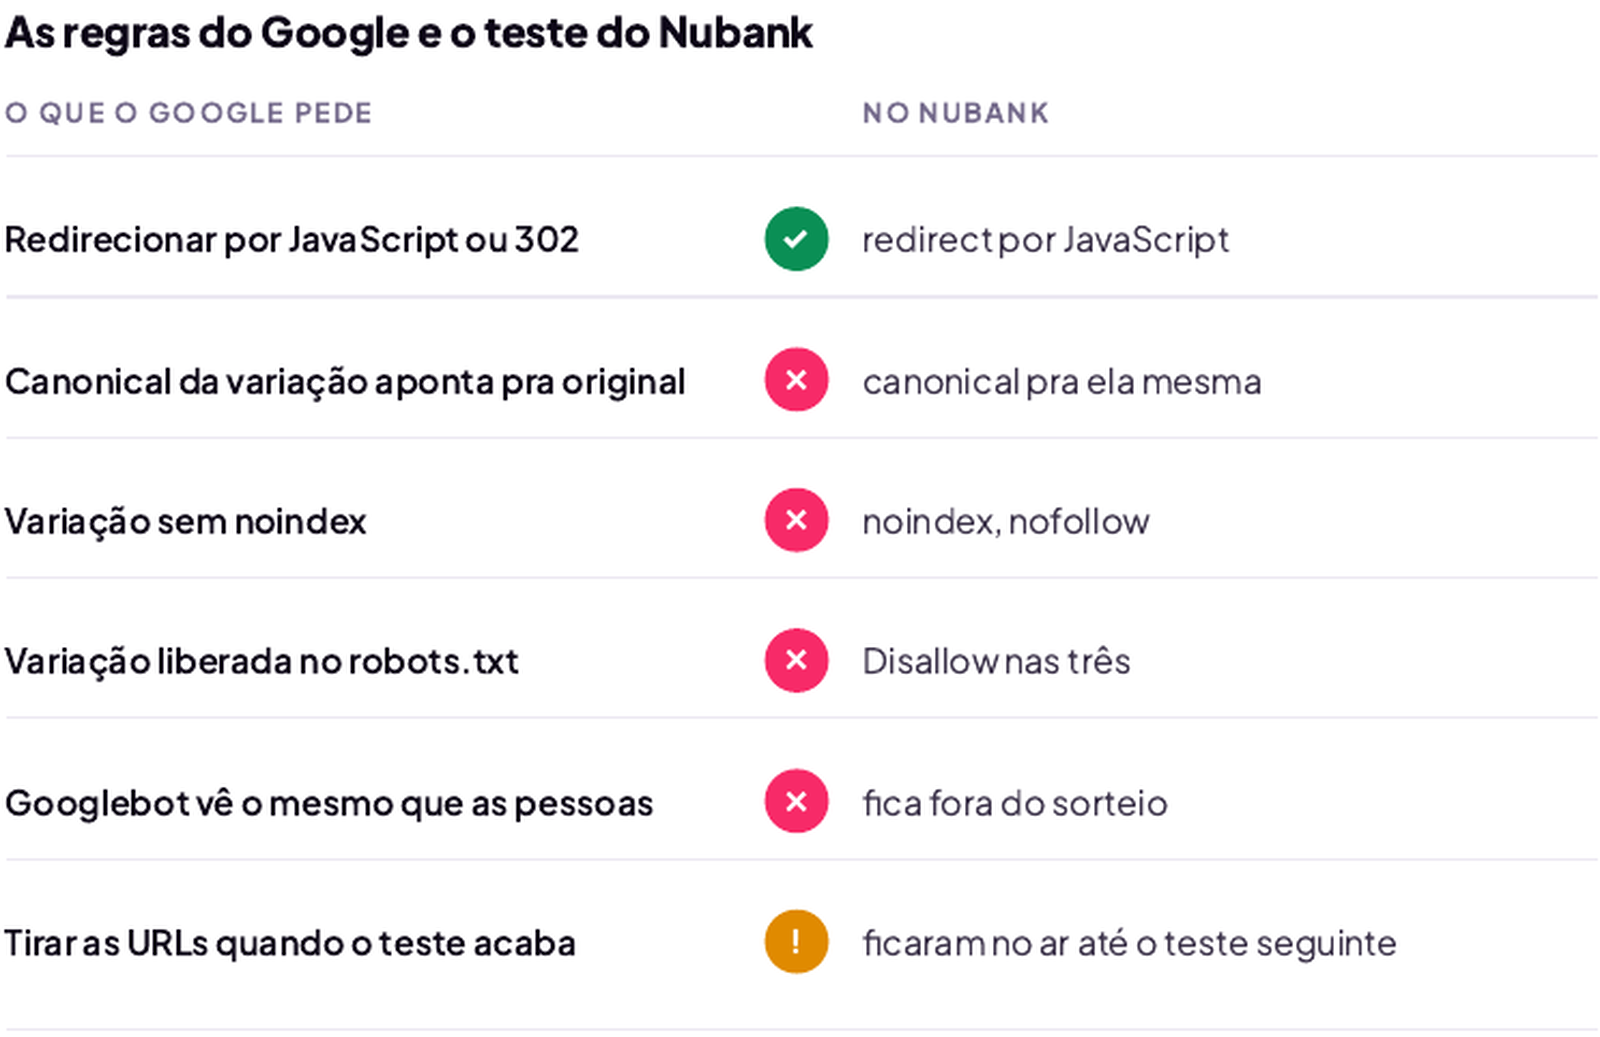
- Sem cloaking. O Googlebot tem que ver o mesmo que as pessoas, em teste ou fora dele.
- Canonical, não noindex. E o exemplo que o Google usa é justamente o de variações da página inicial.
- Redirect temporário. 302 ou JavaScript, nunca 301.
- Só o tempo necessário. Acabou o teste, saem as URLs alternativas e os scripts.
As quatro regras estão publicadas na Central da Pesquisa Google. Os prints abaixo são da página oficial, com os trechos que importam grifados:
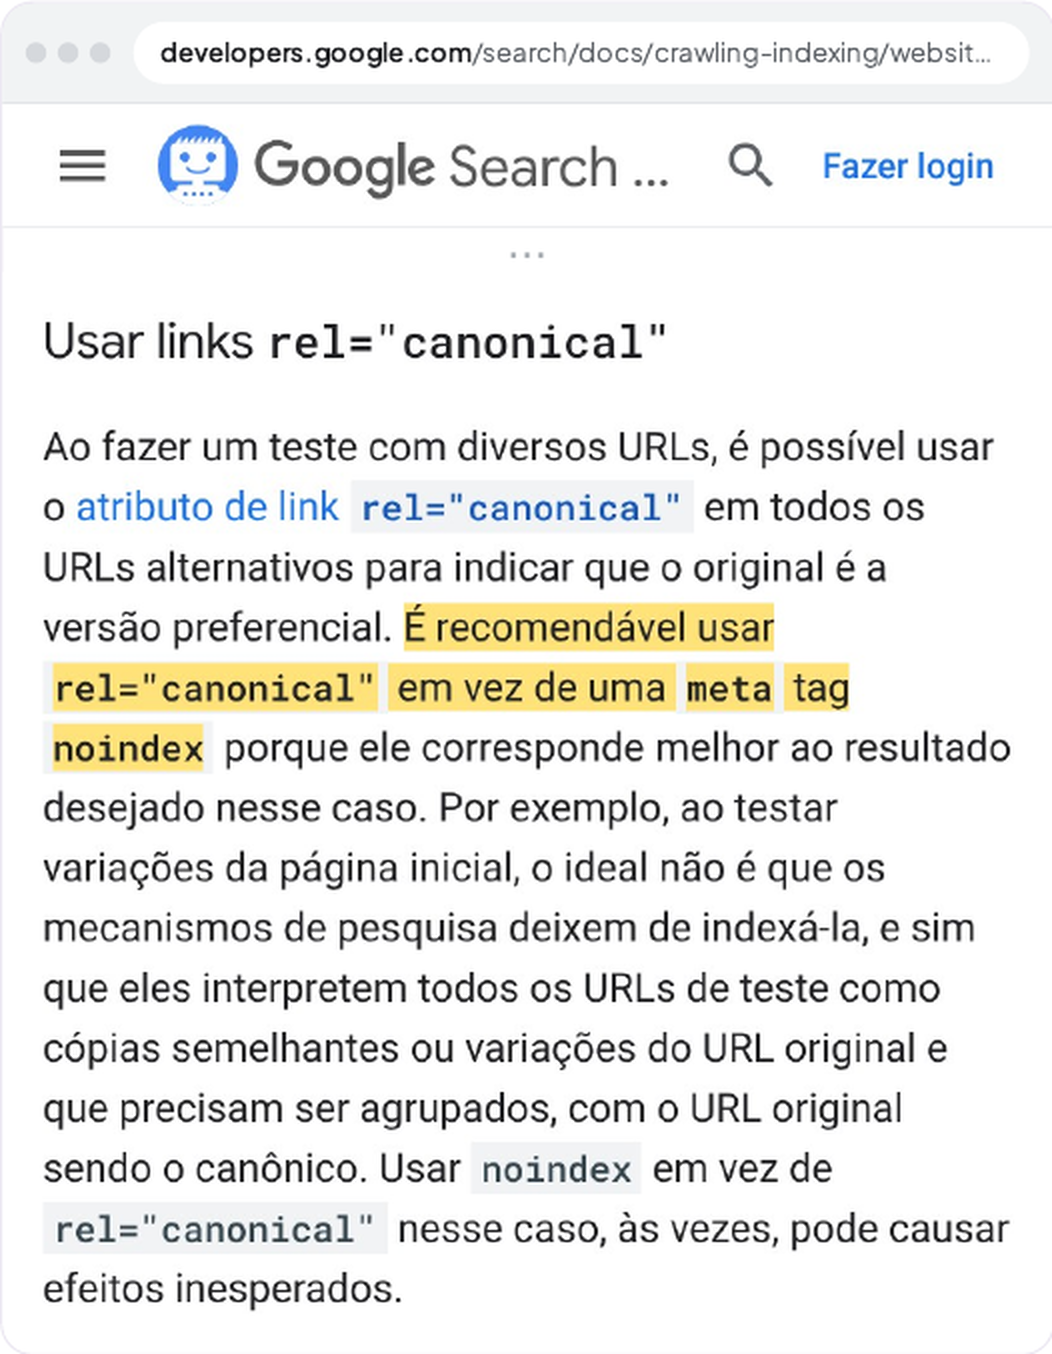
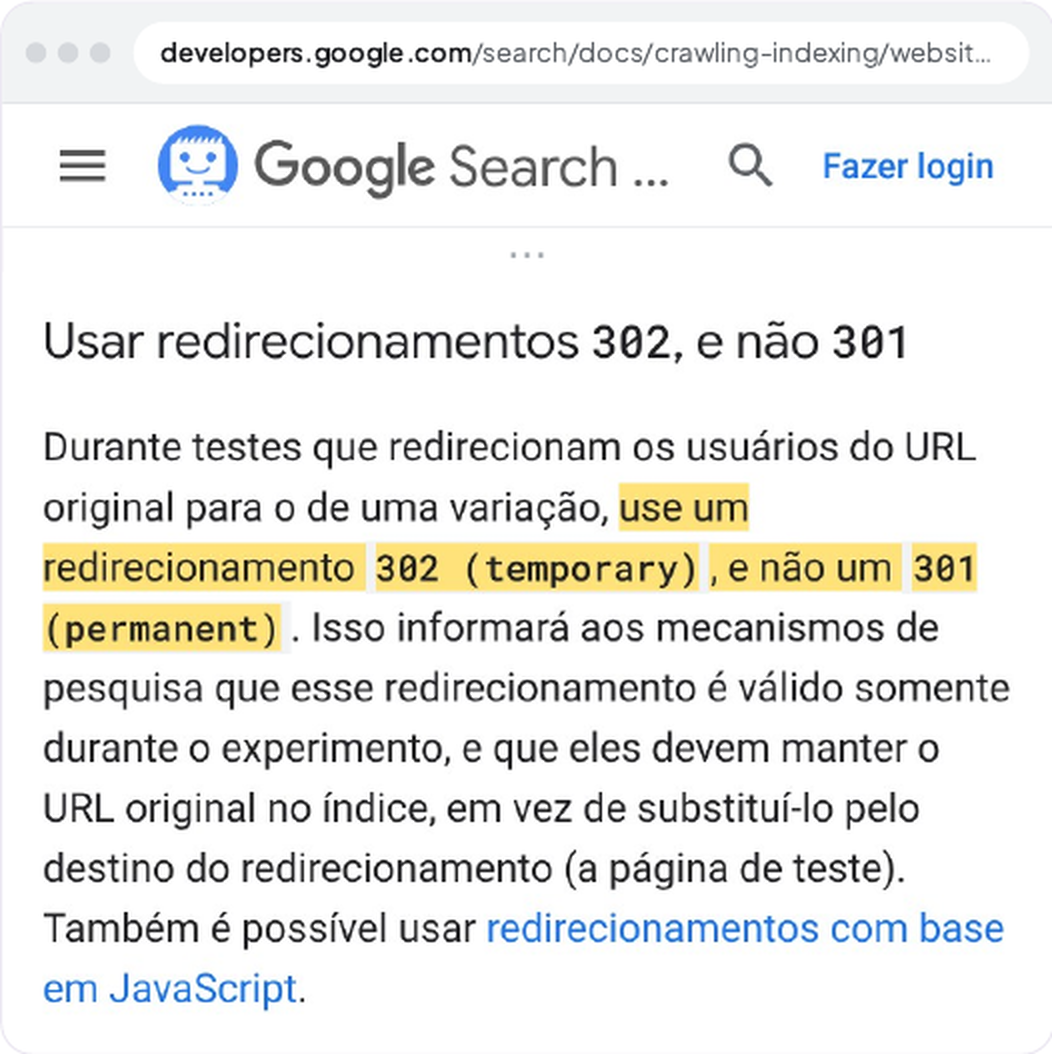
Onde o teste saiu das regras
O redirect do Nubank era por JavaScript, o que é permitido. A home original responde 200, com index, follow e canonical pra ela mesma. Até aqui, tudo certo. Mudou nos quatro pontos seguintes.
O Googlebot ficava fora do sorteio
A FigPii baixa um arquivo de configuração a cada visita. Pedi esse arquivo do mesmo IP, uma vez como Chrome no celular e outra como Googlebot Smartphone. O conteúdo veio igual, mas um header mudou:
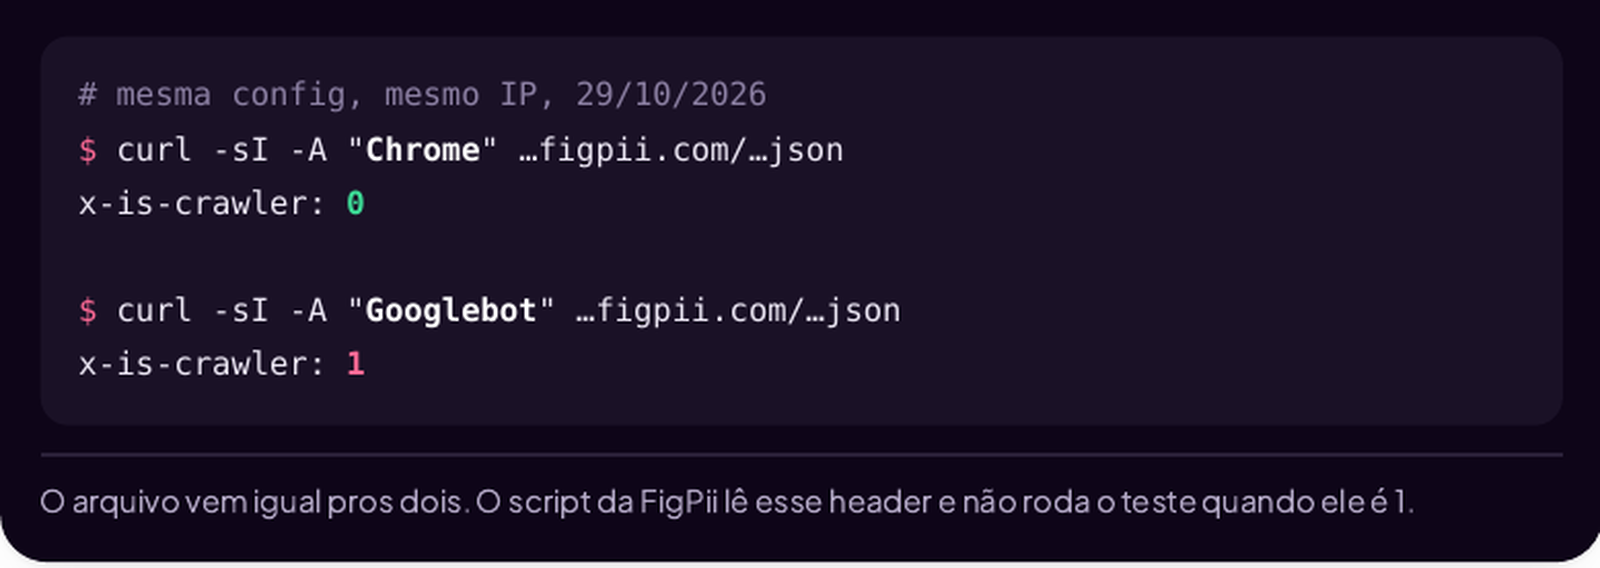
O script da FigPii lê esse header e não roda o teste pra quem é marcado como crawler. Gravei a tela com o teste no ar e, com o user agent do Googlebot, a home ficou parada 27 segundos sem trocar. Em 5 de outubro foram 4 de 4 vezes na original.
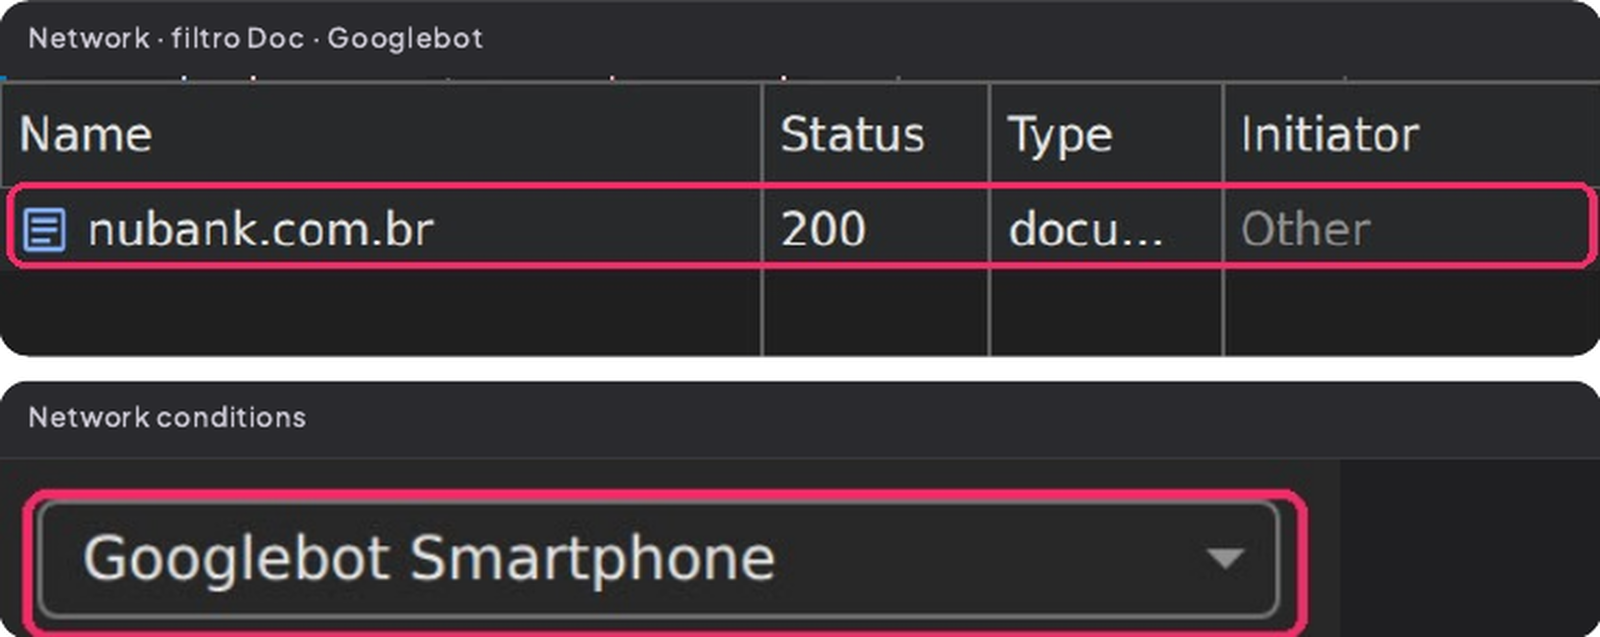
Aqui mora a nuance pra quem é de CRO. Tirar robô da conta do resultado é boa prática, porque robô não converte e suja a amostra. O problema é tirar o robô do sorteio. Com peso 1 na original e 99 nas variações, quase toda pessoa via uma variação, e o Googlebot via sempre a original. É exatamente o que a regra do cloaking pede pra não fazer.
As variações tinham noindex e canonical próprio
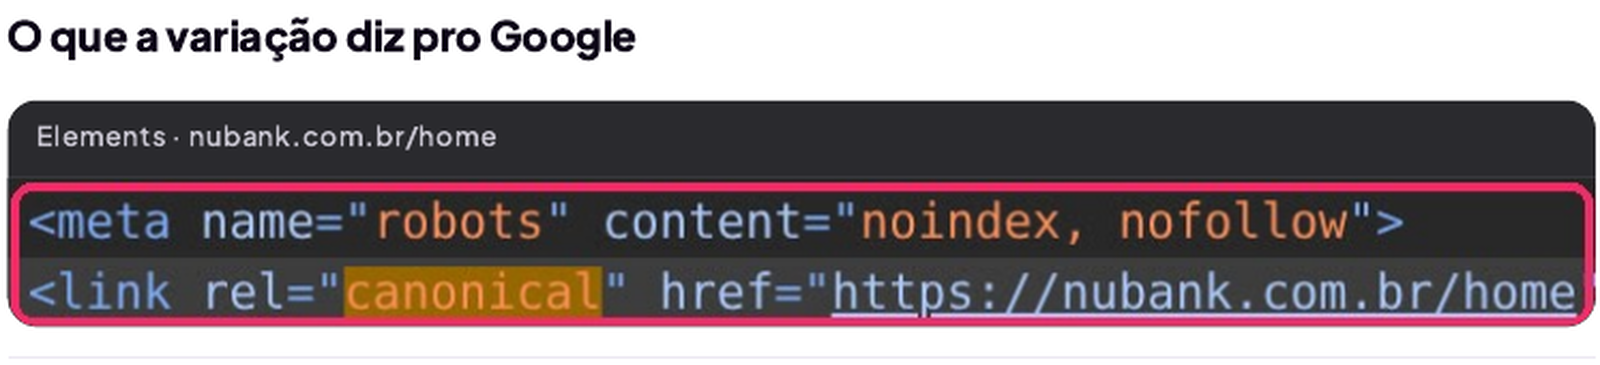
/home, /home2 e /home3 respondem com noindex, nofollow e canonical apontando pra elas mesmas. O Google recomenda o contrário: canonical pra original e sem noindex, pra que todo sinal que a variação recebe volte pra home.
O robots.txt bloqueava as variações
No grupo que vale pro Googlebot, o arquivo tem Disallow: /home, /home2 e /home3. Com a variação bloqueada, o Google nem consegue ler o canonical dela. E o Google avisa que cloaking vale “independentemente de serem feitas pela lógica do servidor, pelo robots.txt ou por qualquer outro método”.
As URLs ficavam no ar entre um teste e outro
Em 7 de outubro, a configuração não listava nenhum experimento ativo, e as três variações seguiam respondendo 200. No dia seguinte, um teste novo voltou a usar as mesmas URLs.
O que mudou até hoje
Conferi de novo em 29 de outubro, por volta das 18h:
A configuração lista um teste novo, “2026-10 NuCoin-Homepage”, com data de 8 de outubro. A original tem peso 34, e duas variações com peso 33 cada mandam pra /home e /home2. O header continua x-is-crawler: 1 pro Googlebot e 0 pro Chrome. As variações seguem com noindex, nofollow e canonical próprio, e o robots.txt segue bloqueando as três. A home original segue certa.
Hoje eu li a configuração, os scripts das variações e o HTML. A troca de página na tela vem das gravações de 5 e 6 de outubro.
O que muda em CRO com os agentes
Voltando à provocação do grupo. Pedi a mesma configuração com outros user agents, e o resultado foi este:
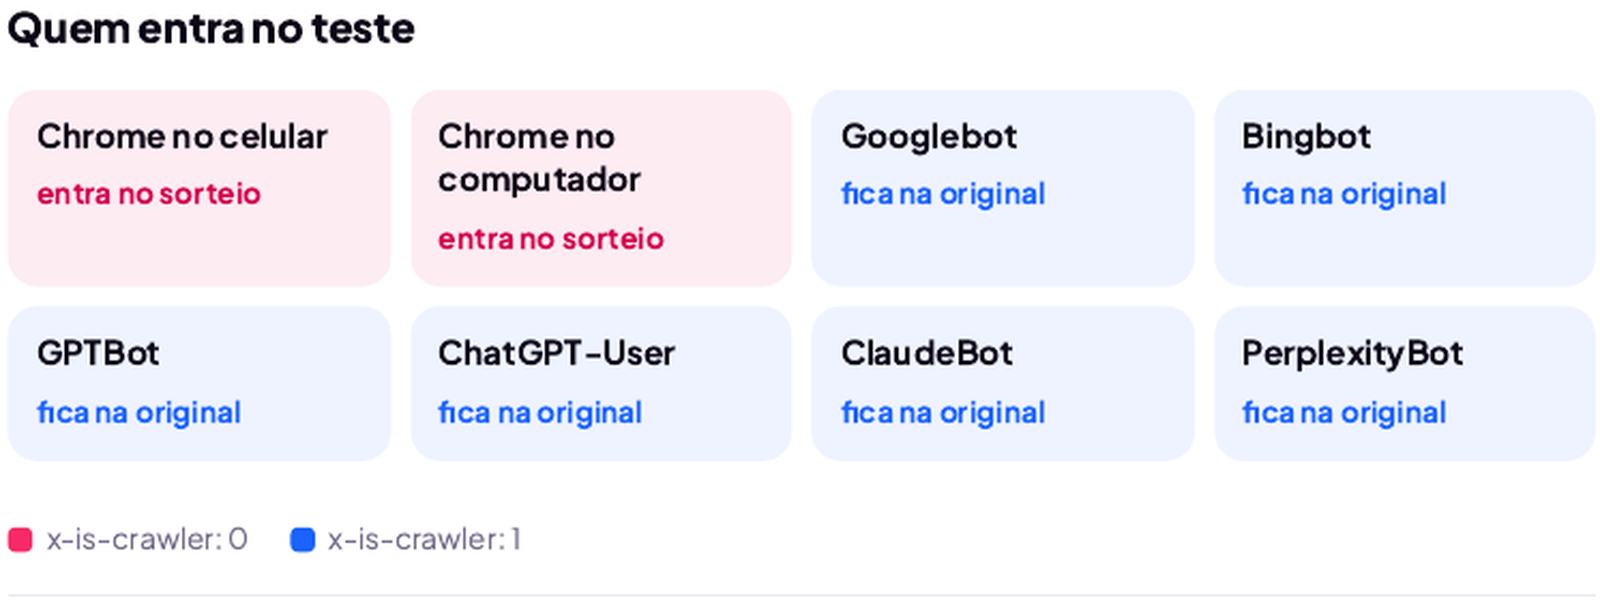
O ChatGPT-User é o que busca uma página quando alguém pede isso ao ChatGPT. Ele é marcado como crawler igual ao Googlebot. Ou seja, o que o assistente lê da home é sempre a original, mesmo quando a maior parte das pessoas está vendo uma variação. Só o Googlebot foi gravado na tela; pros outros, vale o que o código faz com o header.
Dois limites honestos. Vários desses robôs nem rodam JavaScript, então um teste client side já não chegaria neles. E agentes que navegam num Chrome comum, com user agent de navegador, entram no sorteio como se fossem pessoa e contam no resultado.
Pra quem vive de experimentação, isso abre duas perguntas novas: qual versão os agentes estão lendo, e se o resultado do teste vale pra esse tráfego. O teste A/B não morre, mas a pergunta “quem entrou no sorteio?” fica mais importante. Já escrevemos aqui sobre o visitante que é um agente de IA e não clica em nada e sobre como tratar os crawlers de IA no robots.txt.
O que fazer no seu próximo teste
- Variação com canonical pra original e sem noindex. E liberada no robots.txt, pro Google conseguir ler esse canonical.
- Robô entra no sorteio. Pra manter a amostra limpa, filtre robô na análise, não na atribuição. Vale procurar no painel da ferramenta a opção de não excluir crawlers do experimento.
- Se der, sorteie no servidor ou no edge. A pessoa não vê a página trocar, não espera 8 segundos e o Googlebot cai no sorteio como todo mundo. O Google não diz que server side é melhor que client side; as regras valem pros dois. Detalhamos as diferenças em teste A/B client-side x server-side.
- Acabou o teste, limpe. Mande as variações pra versão vencedora com 301 e tire a tag.
Perguntas frequentes
Teste A/B prejudica o SEO?
Não, se seguir as regras do Google: o Googlebot vê o mesmo que as pessoas, a variação tem canonical pra original, o redirect é 302 ou JavaScript e o teste dura só o necessário.
Posso excluir robôs do meu teste A/B?
Da análise, sim, e é boa prática. Do sorteio, não: se o robô vê sempre a original enquanto as pessoas veem outra coisa, isso conta como cloaking pras regras do Google.
Por que noindex é ruim numa variação?
Porque o canonical faz o que você quer, que é dizer ao Google que a variação é a mesma página que a original. O próprio Google diz que usar noindex no lugar pode causar efeitos inesperados.
Como saber se o meu teste segue as regras?
Abra a página em aba anônima, como Chrome e como Googlebot (o DevTools troca o user agent em Network conditions), e compare o que chega. Eu usei a ferramenta grátis de teste A/B da Varrida, que faz essa comparação e lê a configuração pública da ferramenta de teste.
Método e limites
As gravações de tela foram feitas com o teste no ar em 5 e 6 de outubro de 2026, e a configuração, o robots.txt e o HTML foram lidos em 7 e 29 de outubro. Os robôs foram simulados pelo user agent; o Googlebot de verdade vem de IPs do Google, e o que ele indexou fica no Search Console, que o Nubank tem e eu não. O Nubank entrou como exemplo porque todo mundo conhece. O objetivo é ensinar, não apontar dedo, e ninguém pagou por este estudo.
Fontes
- Minimizar o impacto de testes A/B na Pesquisa Google, Google Search Central
- Políticas de spam da Pesquisa Google (cloaking), Google Search Central
Artigos relacionados
- O que é teste A/B? Guia completo com exemplos reais
- Teste A/B client-side x server-side: flicker, SEO e qual usar em cada hipótese
- SEO técnico para IA: rastreamento, robots.txt para crawlers de IA
- Como medir GEO: tráfego de IA no GA4, Search Console e monitoramento de citações
Quer discutir casos como esse com quem vive de experimentação? Faça parte da comunidade CRO Brasil.